Bagaimana Saya Melanjutkan dari Titik Runtime yang Mati Berhenti
On this page
- Pendahuluan
- A. Pekerjaan yang hidup lebih lama dari mesin yang mengerjakannya
- B. Apa yang dimiliki runtime baru saat mulai
- C. Delapan hambatan yang menghalangi
- Metode
- A. Mencegah kematian yang bisa dicegah
- B. Membuat kematian senyap bisa dibaca
- C. Membangun ulang status dari bukti
- D. Menulis dalam urutan yang selamat
- E. Satu definisi untuk yang tersisa
- F. Mesin yang baru setiap kali
- G. Ongkos mulai dari nol
- H. Menunggu disuruh
- Hasil dan Pembahasan
- A. Apa yang dijumlahkan kedelapan keputusan itu
- B. Kematian yang terjadwal
- C. Yang tidak dicakup
- Simpulan
- Istilah
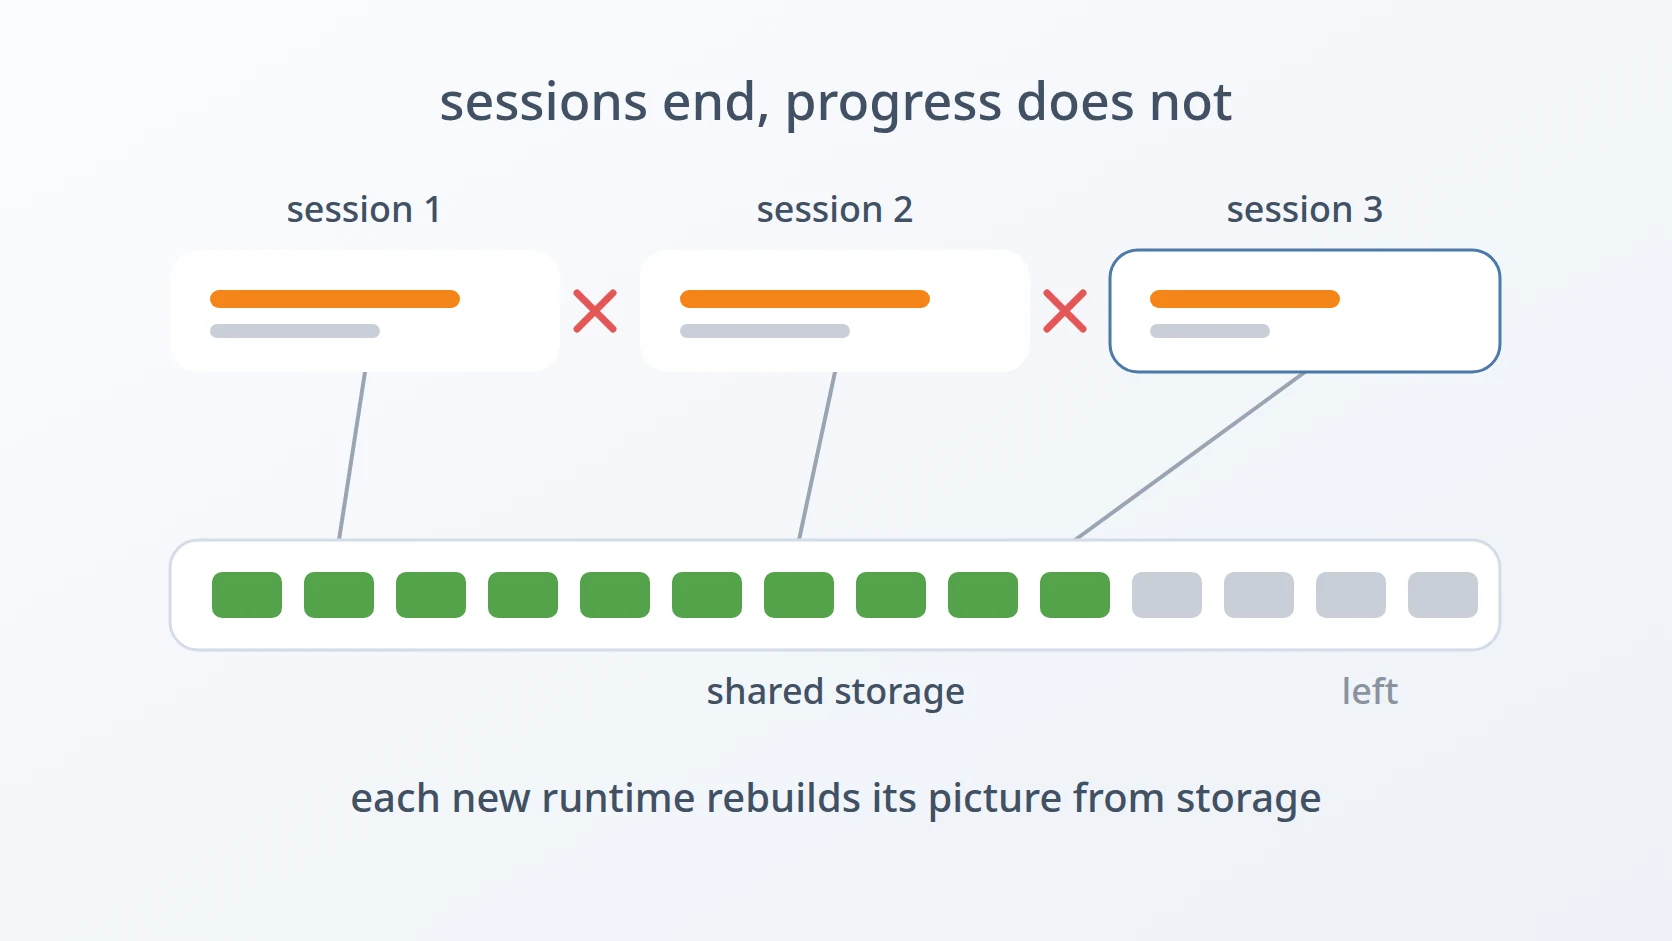
Pendahuluan
A. Pekerjaan yang hidup lebih lama dari mesin yang mengerjakannya
GPU laptop saya punya video memory, atau VRAM, sebesar 4 GB — memori tempat model harus muat supaya bisa berjalan di GPU. Membuat gambar dengan SDXL, model pembuat gambar yang terbuka, butuh jauh lebih dari itu, jadi pembuatannya berjalan di runtime Google Colab — virtual machine yang dipinjamkan Google selama satu sesi — dengan GPU T4 dan sekitar 15 GB VRAM. Laptop menyiapkan pekerjaan dan meninjau hasilnya; runtime mengerjakan bagian yang butuh GPU.
Pekerjaannya panjang. Satu project bisa berarti seratus gambar atau lebih, masing-masing memakan hampir satu setengah menit bila tahap mutunya ikut dihitung, ditambah beberapa menit di awal tiap sesi cuma untuk mengunduh dan memuat model sebelas giga. Satu run yang dihitung dalam jam adalah hal biasa. Makin panjang run-nya, makin kecil peluang ia selesai di dalam satu sesi, jadi pertanyaannya bukan apakah ia akan terpotong, melainkan di mana.
Runtime Colab bukan mesin milik saya. Ia dipinjamkan untuk satu sesi, dan sesinya berakhir. Sebagian cara ia berakhir bisa dicegah — runtime yang dibiarkan menganggur akan dimatikan, dan itu bisa dihalangi. Dua cara lainnya tidak: tiap sesi punya panjang maksimum, dan GPU gratisnya datang dengan kuota harian. Begitu salah satunya habis, runtime-nya lenyap, bersama segala isi memori dan disknya. Tak ada tombol jeda yang bisa ditekan lebih dulu, tak ada kesempatan menyimpan apa pun di detik terakhir.
Tantangannya: melanjutkan dari titik tempat runtime yang mati berhenti — membawa berjam-jam pekerjaan GPU melintasi runtime yang pasti berakhir, tanpa kehilangan yang sudah jadi dan tanpa mengerjakannya dua kali.
Kata yang membentuk seluruh isi di bawah adalah pasti. Ini bukan penanganan error untuk kejadian yang jarang. Runtime-nya akan berakhir, kemungkinan besar di tengah sesuatu, dan runtime berikutnya mulai tanpa apa pun. Merancang untuk itu mengubah bagian mana dari sistem yang jadi jalur utama dan mana yang jadi pengecualian: bertahan dari restart bukan fitur pemulihan yang ditambahkan belakangan, melainkan cara biasa pekerjaan itu berjalan.
Gampang dirumuskan, canggung dibangun. Kesulitannya bukan pada menyimpan hasil — tiap hasil ditulis ke penyimpanan bersama begitu ia ada. Kesulitannya pada segala yang dibutuhkan runtime baru untuk tahu arti hasil-hasil itu: mana yang lengkap, mana yang hilang, mana yang memang tak pernah dibutuhkan, dan apakah ia boleh mulai bekerja sama sekali. Menyimpan itu urusan satu baris; memahami apa yang tersimpan itu urusan seluruh rancangan.
B. Apa yang dimiliki runtime baru saat mulai
Ada gunanya mendaftar apa yang selamat dari berakhirnya sebuah runtime, sebab jumlahnya sangat sedikit, dan daftar pendek itulah yang menentukan seluruh rancangan sesudahnya.
Tak ada isi memori yang selamat. Tiap variabel, tiap antrean, tiap penanda item mana yang sedang berjalan — hilang. Tak ada isi disk runtime yang selamat pula, termasuk tiap model yang diunduh selama sesi itu. Yang selamat adalah penyimpanan bersama di luar runtime, tempat gambar dan record yang menjelaskannya ditulis begitu dihasilkan, serta antarmuka di laptop yang tak pernah berhenti berjalan. Pembagian itulah yang menentukan tempat tinggal tiap potong state: apa pun yang akan dibutuhkan runtime berikutnya wajib sudah ada di penyimpanan, sebab tak ada saat peringatan untuk menaruhnya di sana. Kuota yang habis tak memberi kabar lebih dulu, dan batas sesi pun tidak.
Yang kurang kentara, runtime baru juga bukan mesin yang persis sama dengan yang lama. Library-nya dipasang dari awal ketika cell pertama dijalankan, dari versi apa pun yang kebetulan terbaru hari itu. Code yang berperilaku satu cara pada hari Sabtu bisa berperilaku lain pada hari Senin tanpa satu baris pun berubah.
Jadi runtime baru wajib membangun ulang seluruh gambaran pekerjaannya dari luar, di mesin yang mungkin berbeda dari yang terakhir, dan tanpa memakai GPU untuk apa pun sebelum saya memutuskannya. Ketiga syarat itulah, lebih dari urusan menyimpan hasil, sumber hambatan-hambatannya. Masing-masing juga saling menguatkan: runtime yang tak tahu keadaan sebenarnya lalu langsung bekerja akan memakai kuota untuk mengerjakan item yang keliru, di mesin yang mungkin sudah berperilaku lain.
C. Delapan hambatan yang menghalangi
Sebagian kematian bisa dicegah, sebagian tidak. Runtime yang tampak menganggur akan dimatikan, dan proses di latar tak dihitung sebagai aktivitas. Yang itu bisa dicegah. Batas sesi dan kuota tidak, jadi keduanya harus dirancang untuk dihadapi, bukan dilawan.
Sebagian kematian tak meninggalkan pesan. Runtime yang kehabisan memori sistem tidak diberi tahu. Prosesnya langsung dibunuh, dan log-nya berhenti di tengah baris tanpa error sama sekali.
Status tak boleh tinggal di memori. Apa pun yang diketahui runtime terakhir tentang item mana yang selesai ikut lenyap bersamanya. Runtime berikutnya harus mencari tahu lagi, dari bukti yang bisa dipercaya.
Urutan tulis menentukan apa yang ditinggalkan sebuah kematian. Menyimpan satu hasil berarti menulis satu gambar dan satu record yang menunjuk ke gambar itu. Mati di antara kedua penulisan itu memang akan terjadi, dan satu urutan meninggalkan sisa yang tak berbahaya sementara urutan lain meninggalkan kerusakan permanen.
"Apa yang tersisa" butuh tepat satu definisi. Bila dibiarkan, progress bar, antrean, dan peta status masing-masing membentuk gagasan sendiri soal sisa pekerjaan, dan ketiganya bisa berselisih sampai dua puluh kali lipat.
Tiap runtime baru adalah mesin yang sedikit berbeda. Notebook yang sama yang jalan pada hari Sabtu bisa membeku pada hari Senin, karena perubahan yang tak dibuat siapa pun.
Mulai dari nol ongkosnya dalam giga. Tiap runtime baru mengunduh modelnya lagi. Sebagian adalah harga yang tak terhindarkan dari mesin pinjaman; sebagian ternyata pemborosan.
Runtime baru tak boleh memakai GPU atas kemauannya sendiri. Cara termudah melanjutkan adalah melanjutkan otomatis, begitu runtime tersambung. Itu sengaja tidak dilakukan.
Urutannya bergerak dari kematian itu sendiri, melewati apa yang harus disusun ulang runtime berikutnya, sampai ke apa yang harus dijaga darinya. Dua yang pertama soal bagaimana runtime berakhir; tiga berikutnya soal memulihkan gambaran pekerjaan yang akurat; tiga terakhir soal mulai lagi di mesin yang baru setiap kali.
Metode
A. Mencegah kematian yang bisa dicegah
Inilah jawaban atas hambatan pertama. Colab mematikan runtime yang dianggapnya menganggur, dan ia menilai menganggur dengan sempit: aktivitas di tab browser antarmuka saya sendiri tak dihitung, begitu pula thread di latar. Solusi pertamanya satu cell khusus, dijalankan paling akhir, yang mencetak satu baris status tiap menit:
= 60 # satu denyut per menit
= 60 # bersihkan keluaran kira-kira tiap jamItu bekerja, dan bentuknya keliru. Worker-nya sendiri berjalan di thread latar, dinyalakan cell sebelumnya yang selesai dalam hitungan detik, dan cell keep-alive menjaga runtime tetap hidup tanpa mengerjakan apa pun. Lebih buruk lagi, thread latar mati diam-diam begitu cell yang menyalakannya selesai.
Rancangan belakangan membuang cell keep-alive seluruhnya dengan membuat loop worker sendiri yang memblokir:
# sengaja memblokir: thread daemon mati diam-diam saat cell-nya selesai,
# dan Colab cuma menghitung cell yang memblokir sebagai "berjalan"
...Loop yang memblokir adalah keep-alive bagi dirinya sendiri, dan ia punya manfaat kedua: menghentikan cell langsung menginterupsi loop itu, sehingga code pembersihan sempat berjalan ketimbang thread-nya lenyap begitu saja.
Yang tersisa sesudah itu adalah bagian yang tak bisa dicegah. Batas sesi dan kuota GPU harian mengakhiri runtime menurut jadwalnya sendiri, dan dalam praktiknya cuma keduanya yang melakukannya. Selebihnya dari artikel ini ada karena kedua hal itu.
B. Membuat kematian senyap bisa dibaca
Ini menjawab hambatan kedua. Runtime bisa mati di tengah memuat model, dengan log yang berhenti tepat sesudah peringatan rutin dari library dan tepat sebelum baris yang mengumumkan model sudah siap — tanpa traceback sama sekali.
Tanpa traceback berarti tanpa exception: prosesnya dibunuh dari luar. Di antara kedua baris log itu cuma ada satu operasi, yakni memindahkan model ke GPU. Selama penyalinan itu, bobotnya ada di memori sistem dan di video memory sekaligus, dan tier gratis punya sekitar 12,7 GB memori sistem. Tanpa pengukuran, sebab itu cuma kesimpulan, bukan pengamatan.
Jadi paruh pertama jawabannya bukan perbaikan. Ia membuat sebabnya terlihat kapan pun itu terjadi, dengan pengukuran dari sumber yang tak menyesatkan:
# MemAvailable, bukan MemFree: MemFree mengabaikan cache yang bisa diambil kembali
return / 1024 / 1024
return -1.0Video memory dibaca dari nvidia-smi, bukan dari allocator milik framework-nya, yang cuma melihat alokasinya sendiri. Keduanya dicatat sebelum dan sesudah tiap langkah yang kalau tidak begitu akan gelap.
Paruh keduanya menurunkan puncak pemakaian, yang itulah yang membuat proses dibunuh, bukan totalnya. Rujukan ke image encoder dilepas begitu pipeline memegangnya, ketimbang menahan sekitar 2,5 GB sepanjang sisa fungsi. Dan model dipindahkan ke GPU satu komponen demi satu komponen, dengan memori diambil kembali di antaranya:
=
continue
Alternatif yang terdengar paling menjanjikan ditolak sesudah dokumentasinya dibaca. Penempatan perangkat otomatis milik library itu ditandai eksperimental, cuma mendukung satu strategi untuk pipeline, dan bentrok dengan pemanggilan .to() eksplisit yang sudah dilakukan code-nya. Memakainya berarti menukar risiko yang dipahami dengan risiko yang tidak.
C. Membangun ulang status dari bukti
Ini menjawab hambatan ketiga. Runtime baru tak bertanya apa yang sedang dikerjakan runtime sebelumnya. Ia membangun ulang seluruh peta status dari apa yang ada di penyimpanan, tiap kali sebuah project dibuka:
=
return and in Sebuah item dihitung selesai cuma bila dua fakta yang saling lepas sepakat: record-nya menunjuk sebuah gambar, dan gambar itu memang ada. Salah satunya saja keliru dengan cara yang sudah pernah terjadi. Memeriksa file saja akan menghitung gambar nyasar sebagai penyelesai item yang record-nya menyatakan belum ada yang dibuat. Memeriksa record saja akan menghitung item sebagai selesai sesudah gambarnya terhapus.
Mengetahui file mana yang ada harus murah, sebab itu terjadi tiap kali mulai. Memeriksa tiap item satu per satu ke penyimpanan berarti 2.131 request terpisah. Dua listing folder gambar memberi jawaban yang sama:
return
return Akibatnya, runtime yang dibunuh pada saat apa pun tak meninggalkan apa pun yang perlu diberitahukan kepada runtime berikutnya. Kebenarannya ada di penyimpanan; memori cuma pernah memegang salinannya.
D. Menulis dalam urutan yang selamat
Ini menjawab hambatan keempat. Menyimpan satu hasil butuh dua penulisan: file gambarnya, dan record yang menyatakan gambar mana milik item ini. Runtime bisa mati di antara keduanya. Cepat atau lambat, itu akan terjadi.
= # gambar lebih dulu
# lalu record-nya
= # baru sesudah keduanyaDengan gambar ditulis lebih dulu, kematian di antaranya meninggalkan gambar yang tak ditunjuk record mana pun — satu file terbuang, tak berbahaya, dan tak pernah ditampilkan. Dengan record ditulis lebih dulu, kematian di antaranya meninggalkan record yang menunjuk gambar yang tak ada. Dengan aturan dua syarat di atas item itu akan tertangkap; tanpa aturan itu ia akan tampak selesai selamanya sambil tak menampilkan apa-apa.
Status ditandai selesai cuma sesudah record-nya tertulis dengan aman, dengan alasan yang sama. Dan gambar tak pernah ditimpa: tiap gambar disimpan dengan nama berversi yang baru, jadi menulis lagi sesudah crash tak mungkin merusak file yang sudah ditunjuk sebuah record.
E. Satu definisi untuk yang tersisa
Ini menjawab hambatan kelima. Tanpa satu definisi, pertanyaan paling dasar sesudah restart — berapa yang tersisa — mendapat tiga jawaban berbeda, seperti ditunjukkan pengukuran pada project sungguhan:
# "sisa pekerjaan", tiga versi, pada project yang sama
Progress bar yang menghitung segala yang ada, termasuk ratusan shot yang belum disiapkan, takkan pernah bisa sampai di ujung. Antrean yang menghitung tiap state object yang punya prompt ikut memuat state yang tak dipakai shot siap mana pun — berjam-jam waktu GPU untuk gambar yang takkan dilihat siapa pun.
Jawabannya satu fungsi yang mendefinisikan apa yang perlu dibuat, dipakai bersama oleh antrean dan perhitungan progres, sehingga keduanya tak bisa lagi berselisih. Satu pembedaan sengaja dipertahankan. Peta status tidak dipersempit ke definisi itu. Ia mencatat apa yang teramati benar di dunia — apakah gambar ini ada — sementara work set mencatat apa yang diniatkan. Menyatukan keduanya akan membuat gambar tak terpakai yang sudah pernah dibuat tampak tertunda, lalu dibuat ulang tanpa guna.
F. Mesin yang baru setiap kali
Ini menjawab hambatan keenam. Notebook yang berjalan benar pada hari Sabtu bisa, pada hari Senin dan tanpa perubahan apa pun di repository, berhenti persis sesudah progress bar gambar pertama sampai di ujungnya — tak ada baris baru, tak ada error, cell-nya masih tertanda berjalan.
Bedanya ada di runtime. Runtime baru memasang library-nya dari awal, jadi library yang gagal diimpor pada hari Sabtu bisa berhasil diimpor pada hari Senin. Itu menyalakan fitur mutu opsional, yang mengunduh model penilai 600 MB saat pertama kali dibutuhkan — tanpa batas waktu, dan sambil memegang lock yang memberi satu tugas hak tunggal atas GPU. Bila unduhannya menggantung, selama itu ia menyandera GPU. Sabtu berjalan hanya karena sebuah library gagal terpasang.
Dua keputusan menjawabnya. Model opsional dimuat sebelum mengambil lock GPU, jadi unduhan yang lambat menunda satu item tanpa membekukan sisanya:
Dan tiap pemuatan semacam itu berjalan dengan batas waktu, sambil mengumumkan dirinya sebelum mulai:
# umumkan lebih dulu, supaya hang punya alamat
=
... # berhenti menunggu, lanjut tanpa fitur ituAturan di balik keduanya: tahap mutu yang opsional boleh menurunkan mutu, dan tak boleh lebih dari itu. Ia tak pernah boleh menghentikan pembuatan gambar. Batas waktu yang mundur ke "tanpa fitur ini" yang menegakkannya. Mencetak sebelum unduhan dimulai berarti bila ada yang menggantung, log-nya menyebut di mana.
G. Ongkos mulai dari nol
Ini menjawab hambatan ketujuh. Tiap runtime baru mengunduh kira-kira sepuluh giga bobot model sebelum bisa membuat apa pun. Menyimpannya di penyimpanan bersama sudah dicoba lalu ditinggalkan: dengan 2–4 MB/s yang dicapai penyimpanan itu, mengunggah bobotnya memakan puluhan menit lebih lama ketimbang mengunduhnya ulang dari sumber publiknya. Unduhan ulang diterima sebagai harga mesin pinjaman.
Menerima ongkos tak sama dengan mengabaikannya. Pola unduhan ber-wildcard akan mengambil folder image encoder, yang memuat bobot yang sama dalam dua format — 2,53 GB dua kali di setiap sesi. Karena itu unduhannya menyebut tiap file:
= Unduhan yang terjadi sekali gampang dibiarkan boros. Unduhan yang terjadi di awal tiap sesi, di jam yang sudah berjalan mundur, pantas dibaca baris demi baris.
H. Menunggu disuruh
Ini menjawab hambatan kedelapan. Ketika runtime baru tersambung, ia memuat model, mengumumkan dirinya online, lalu menunggu. Ia tak melihat antrean lalu mulai. GPU baru dipakai sesudah saya menekan Mulai di antarmuka:
= # None sampai Mulai ditekan di antarmuka
= None
...Project saya yang lain, pengubah PDF, melakukan sebaliknya: begitu tersambung ia memindai pekerjaan yang tertunda lalu langsung mulai. Untuk project itu, itulah pilihan yang tepat. Untuk project ini ia ditolak, dengan empat alasan. Runtime yang melanjutkan sendiri bisa menghabiskan kuota GPU harian untuk seratus item sebelum saya menyadarinya. Di antara sesi saya sering ingin membetulkan prompt sebelum ada yang dibuat lagi. Bisa ada lebih dari satu project, dan worker tak bisa tahu yang mana yang saya maksud. Dan penantian itu tak mahal, sebab model tetap termuat selama worker menunggu — melepasnya lalu memuatnya lagi akan makan menit-an tiap kali.
Dengan kata lain, melanjutkan adalah keputusan, bukan refleks. Tugas runtime adalah siap; memakainya atau tidak adalah keputusan saya.
Hasil dan Pembahasan
A. Apa yang dijumlahkan kedelapan keputusan itu
Sebuah sesi kini bisa berakhir pada titik mana pun tanpa kehilangan hasil yang sudah jadi maupun meninggalkan hasil yang rusak, dan sesi berikutnya memungut sisa pekerjaannya — sisa yang benar — begitu saya menyuruhnya.
| Keputusan | Yang dibeli | Alternatif yang ditolak |
|---|---|---|
| loop worker memblokir | keep-alive bagi dirinya; interupsi sampai kepadanya | cell keep-alive terpisah di samping thread latar |
| memori diukur sebelum langkah gelap | kematian senyap meninggalkan bukti | menebak dari tempat log berhenti |
| pindah ke GPU per komponen | puncak memori lebih rendah | penempatan perangkat otomatis — eksperimental |
| status dibangun ulang dari penyimpanan | tak ada yang perlu diberitahukan ke runtime berikutnya | memercayai ingatan runtime terakhir |
| record dan file wajib sepakat | file nyasar dan gambar terhapus sama-sama tertangkap | memeriksa salah satunya saja |
| gambar dulu, record kemudian | kematian meninggalkan sisa yang tak berbahaya | record dulu — penunjuk ke kekosongan |
| satu definisi sisa pekerjaan | 101 item, bukan 2131 atau 353 | tiap bagian menghitung dengan caranya sendiri |
| model opsional dimuat sebelum lock, dengan batas waktu | hang cuma mengorbankan satu fitur, bukan GPU | pemuatan malas di dalam lock |
| tiap file disebut dalam unduhan | 2.53 GB dihemat tiap sesi | pola wildcard |
| menunggu Mulai | kuota terpakai cuma saat diniatkan | melanjutkan otomatis saat tersambung |
B. Kematian yang terjadwal
Benang merahnya adalah perubahan andaian. Kebanyakan software memperlakukan kematiannya sendiri sebagai pengecualian, dan menaruh penanganannya di pinggir. Runtime pinjaman membalik itu: berakhir adalah satu-satunya kejadian yang pasti, jadi jalur biasa harus dibangun mengelilinginya.
Itu tampak di tempat-tempat yang tak gemerlap. Itulah sebabnya status dibangun ulang dari penyimpanan ketimbang diingat, sebabnya gambar ditulis sebelum record-nya, sebabnya ada satu definisi sisa pekerjaan dan bukan tiga, dan sebabnya runtime baru menunggu ketimbang langsung menerjang. Tak satu pun mekanisme pemulihan. Masing-masing cuma cara jalur biasa bekerja begitu ia mengandaikan dirinya akan diinterupsi.
Benang keduanya: runtime baru itu baru dalam lebih banyak hal ketimbang memorinya yang kosong. Ia memasang versi library yang berbeda, mengunduh modelnya dari nol, dan bisa mati dengan cara yang tak berkata apa-apa. Membuat masing-masing terlihat — memori dicatat sebelum langkah berisiko, pesan dicetak sebelum tiap unduhan, batas waktu pada apa pun yang opsional — mengubah berhentinya yang misterius jadi berhenti yang bisa dijelaskan keesokan paginya.
Versi umumnya: ketika berakhirnya sebuah mesin sudah pasti, berhentilah merancang pemulihan dan mulailah merancang jalur biasa supaya ia tak punya apa pun untuk dipulihkan.
C. Yang tidak dicakup
Satu item yang sedang dikerjakan ketika runtime mati akan hilang dan dikerjakan lagi dari awal. Dengan item yang makan jauh di bawah dua menit, checkpoint yang lebih halus tak sepadan dengan kerumitannya; untuk pekerjaan yang satu itemnya makan berjam-jam, ia sepadan.
Ini juga satu worker. Dua runtime yang mengerjakan project yang sama pada saat bersamaan butuh cara mengklaim item, supaya keduanya tak membuat gambar yang sama. Rancangannya mengandaikan itu tak pernah terjadi, dan untuk satu orang dengan satu GPU pinjaman, memang tidak.
Simpulan
GPU 4 GB mengirim berjam-jam pembuatan gambar ke runtime Colab, dan tiap runtime Colab berakhir — oleh batas sesi atau kuota harian, mana yang datang lebih dulu. Pemadaman karena menganggur bisa dicegah, dan memang dicegah, dengan menjadikan loop worker sendiri yang menjaga runtime tetap sibuk. Selebihnya cuma bisa direncanakan.
Merencanakannya berarti memperlakukan tiap runtime baru sebagai mesin yang tak tahu apa-apa dan bahkan mungkin bukan mesin yang sama. Ia membangun ulang statusnya dari penyimpanan, memercayai sebuah item selesai cuma bila record dan file-nya sepakat. Ia bersandar pada hasil yang sudah ditulis dalam urutan yang tak bisa dirusak crash. Ia memakai satu definisi untuk yang tersisa. Ia memuat model opsional di luar lock GPU dan dengan batas waktu, dan ia menunggu disuruh sebelum memakai kuotanya.
Yang terbawa ke mana-mana adalah perubahan andaian itu. Ketika berakhirnya sebuah mesin sudah pasti, pemulihan berhenti jadi fitur dan berubah jadi rancangan jalur biasa.
Istilah
- runtime
- Satu sesi Colab: mesin virtual sementara, dengan memori, disk, dan GPU sendiri, yang cuma ada sampai sesinya berakhir.
- keep-alive
- Apa pun yang mencegah runtime dinilai menganggur lalu dimatikan. Di sini, cell yang code-nya memblokir selama pekerjaannya berlanjut.
- OOM
- Out of memory. Ketika memori sistem habis, sistem operasi langsung membunuh proses, jadi tak ada error yang muncul di dalam programnya.
- puncak memori
- Jumlah memori tertinggi yang terpakai pada satu saat. Proses bisa dibunuh di puncaknya walau rata-rata pemakaiannya jauh di bawah batas.
- lock GPU
- Lock yang memastikan cuma satu tugas memakai GPU pada satu waktu. Apa pun yang lambat dikerjakan sambil memegangnya akan menahan tiap tugas lain yang menunggu GPU.
- work set
- Satu-satunya definisi item mana yang masih perlu dibuat, dipakai bersama oleh antrean dan tampilan progres supaya keduanya tak bisa berselisih.
Technologies covered
- Python
- Google Colab
- GPU
- SDXL
