Bagaimana Saya Menjalankan Web Server Laravel dan Worker Antreannya dalam Satu Container
On this page
- Pendahuluan
- A. Dua proses yang sama-sama enggan berakhir
- B. Kenapa satu container membuat ini canggung
- C. Istilah yang dipakai sepanjang tulisan
- D. Bentuk jawabannya
- E. Lima hambatan yang menghalangi
- Metode
- A. Kecepatan lebih dulu: kenapa runtime ini, bukan yang biasa
- B. Entrypoint menyiapkan, lalu menyingkir
- C. Tiga program di bawah satu supervisor
- D. Kenapa tujuh belas worker di mesin enam belas inti
- E. Dua batas waktu yang urutannya tak boleh terbalik
- F. Menyusun urutan build supaya cache-nya benar-benar menolong
- Hasil dan Pembahasan
- A. Seberapa berharga urutan build tadi
- B. File sepuluh megabita yang bisa lenyap tanpa pesan error
- C. Wujud container ini dilihat dari luar
- Simpulan
- Istilah
Pendahuluan
Aplikasi web yang kerjanya hanya menjawab request itu mudah dikemas. Ada yang datang, aplikasi bekerja beberapa ratus milidetik, menjawab, selesai. Satu program, satu tugas, satu container. Begitulah tooling container dirancang, dan selama perangkat lunak kita berbentuk seperti itu, semua yang mengikutinya — deploy, penskalaan, restart, pencatatan log — berjalan tanpa perdebatan.
Aplikasi yang harus saya kemas tidak berbentuk seperti itu. Selain menjawab HTTP, ia juga mengirim email, memanggil balik sistem klien yang sedang menunggu jawabannya, menandatangani dokumen, dan membuat gambar pratinjau dari file yang diunggah orang. Pekerjaan jenis pertama berbentuk request. Jenis kedua sama sekali tidak, dan memaksanya jadi request berarti membiarkan user menatap ikon berputar selama sebuah PDF ditandatangani.
Jadi ada dua jenis pekerjaan berumur panjang dalam satu basis kode, sementara susunan container yang paling lazim tak menyediakan tempat untuk jenis kedua. Itulah tantangan yang dibahas tulisan ini: bagaimana keduanya akhirnya berjalan di dalam satu image container, kenapa itu lebih rumit daripada kedengarannya, dan apa harganya.
A. Dua proses yang sama-sama enggan berakhir
Pekerjaan yang sebaiknya tidak dikerjakan selagi request berlangsung ditunda. Aplikasi mencatat apa yang perlu dikerjakan lalu langsung menjawab; pihak lain mengambil catatan itu belakangan dan mengerjakannya. Di basis kode ini ada dua puluh satu jenis pekerjaan tertunda, dan polanya seragam: mengirim email kepada user yang baru mengganti kata sandi, mengabari sistem klien bahwa sertifikatnya disetujui, menandatangani dokumen yang diunggah, membuat gambar pratinjau. Hampir semuanya menunggu sesuatu di luar sana — mail server, endpoint HTTP milik organisasi lain, atau disk.
Mengerjakan pekerjaan semacam itu menuntut adanya proses yang sudah berjalan sebelum pekerjaannya datang, sebab datangnya tak bisa diramalkan. Proses itu tak mungkin dinyalakan oleh request, karena justru intinya tak ada request yang menunggu. Ia harus sudah ada di sana, bertanya berulang-ulang apakah ada yang perlu dikerjakan.
Di sisi lain, web server juga proses yang sudah berjalan sebelum request pertama tiba, menunggu di sebuah socket. Keduanya berumur panjang. Keduanya harus selamat dari kegagalan. Keduanya harus dimatikan dengan hati-hati. Tapi panjang umurnya berbeda jenis, dan justru perbedaan itulah seluruh persoalannya. Web server yang mati di tengah request kehilangan satu jawaban, dan kliennya akan mencoba lagi. Worker antrean yang mati di tengah job bisa saja sudah menagih sesuatu, sudah mengirim sesuatu, atau sudah menuliskan separuh tanda tangan ke dalam file.
B. Kenapa satu container membuat ini canggung
Container adalah cara mengemas sebuah program bersama segala yang dibutuhkannya — library sistem operasi, runtime bahasa, konfigurasi — menjadi satu image yang berjalan sama di mesin mana pun yang bisa menjalankan container. Konvensinya kuat, dan itu konvensi yang baik: satu container menjalankan satu program. Begitu programnya berhenti, container itu selesai. Justru itu yang membuat container mudah dinalar, sebab sehatnya container sama dengan sehatnya program.
Dua program langsung mematahkan kesamaan itu. Yang mana yang disebut container? Kalau web server-nya sehat sementara seluruh worker antreannya mati, apakah container itu sehat? Runtime container tak sanggup menjawabnya, sebab ia hanya mengawasi satu proses.
Pilihan yang jujur adalah membangun dua image, atau menjalankan image yang sama dua kali dengan perintah berbeda — satu melayani HTTP, satunya menjalankan worker. Banyak tim melakukan persis itu, dan untuk sistem besar itulah jawaban yang benar. Untuk project ini saya memutuskan bukan, sebab kedua deployment itu akan berbagi semua yang justru penting: basis kode yang sama, dependency yang sama, konfigurasi yang sama, kredensial database yang sama, versi yang sama. Tiap rilis berarti membangun dan mengirim kode yang sama dua kali sambil berharap kedua belahannya mendarat bersamaan. Worker yang menjalankan kode pekan lalu di atas skema database pekan ini adalah sore hari yang sungguh buruk.
Sebaliknya, satu image berarti satu kali bangun, satu nomor versi, satu benda yang di-deploy, satu aliran log, dan mustahil kedua belahannya berpisah jalan. Harganya, container itu tak lagi mengawasi dirinya sendiri, dan sesuatu di dalamnya harus mengambil alih tugas tersebut.
C. Istilah yang dipakai sepanjang tulisan
Istilah berikut muncul terus, dan dua di antaranya bertabrakan secara menyesatkan, jadi sebaiknya dibereskan lebih dulu.
Queue adalah daftar pekerjaan yang menunggu dikerjakan. Job adalah satu butir dalam daftar itu — pada praktiknya catatan kecil yang menyebut kelas mana yang harus dijalankan dan dengan data apa. Worker adalah proses yang berulang kali mengambil job berikutnya dari queue, menjalankannya, lalu meminta job lagi. Di sini queue-nya berupa tabel di database, jadi satu job adalah satu baris dan mengambil job berarti sebuah transaksi.
Worker mode adalah gagasan yang sama sekali lain namun sialnya memakai kata yang sama. Biasanya aplikasi PHP dimuat dari nol pada tiap request: framework di-boot, konfigurasi dibaca, route didaftarkan, lalu semuanya dibuang begitu jawaban terkirim. Worker mode sebaliknya mem-boot aplikasi sekali di dalam proses berumur panjang, lalu memakai ulang aplikasi itu untuk banyak request. Kata "worker" di sini menunjuk proses yang memegang aplikasi ter-boot, bukan proses yang menjalankan job. Bila tulisan ini menyebut worker antrean, yang dimaksud makna kedua; worker mode selalu berarti yang pertama.
PID 1 adalah proses pertama yang dijalankan di dalam container. Perannya lebih besar dari kesan namanya: begitu PID 1 berhenti, container ikut berhenti, apa pun yang masih berjalan di dalamnya. Ia juga yang menerima sinyal penghentian ketika ada yang meminta container berhenti, dan ia pula yang bertanggung jawab meneruskan sinyal itu.
Process manager, atau supervisor, adalah program yang tugas satu-satunya menyalakan program lain, mengawasinya, dan menyalakannya kembali bila mati. Ia sendiri tak mengerjakan apa pun.
Reverse proxy adalah server yang ditempatkan di depan aplikasi, menerima request dari dunia luar lalu meneruskannya ke dalam. Umumnya ia yang menuntaskan HTTPS, sehingga aplikasi di belakangnya cukup berbicara HTTP biasa.
Layer adalah hasil satu instruksi di file build; image berupa tumpukan layer. Build cache memakai ulang layer yang sudah ada selama instruksi dan masukannya tak berubah. Multi-stage build adalah satu file build yang memuat beberapa proses bangun terpisah, di mana tahap belakangan menyalin file pilihan dari tahap sebelumnya dan meninggalkan sisanya.
D. Bentuk jawabannya
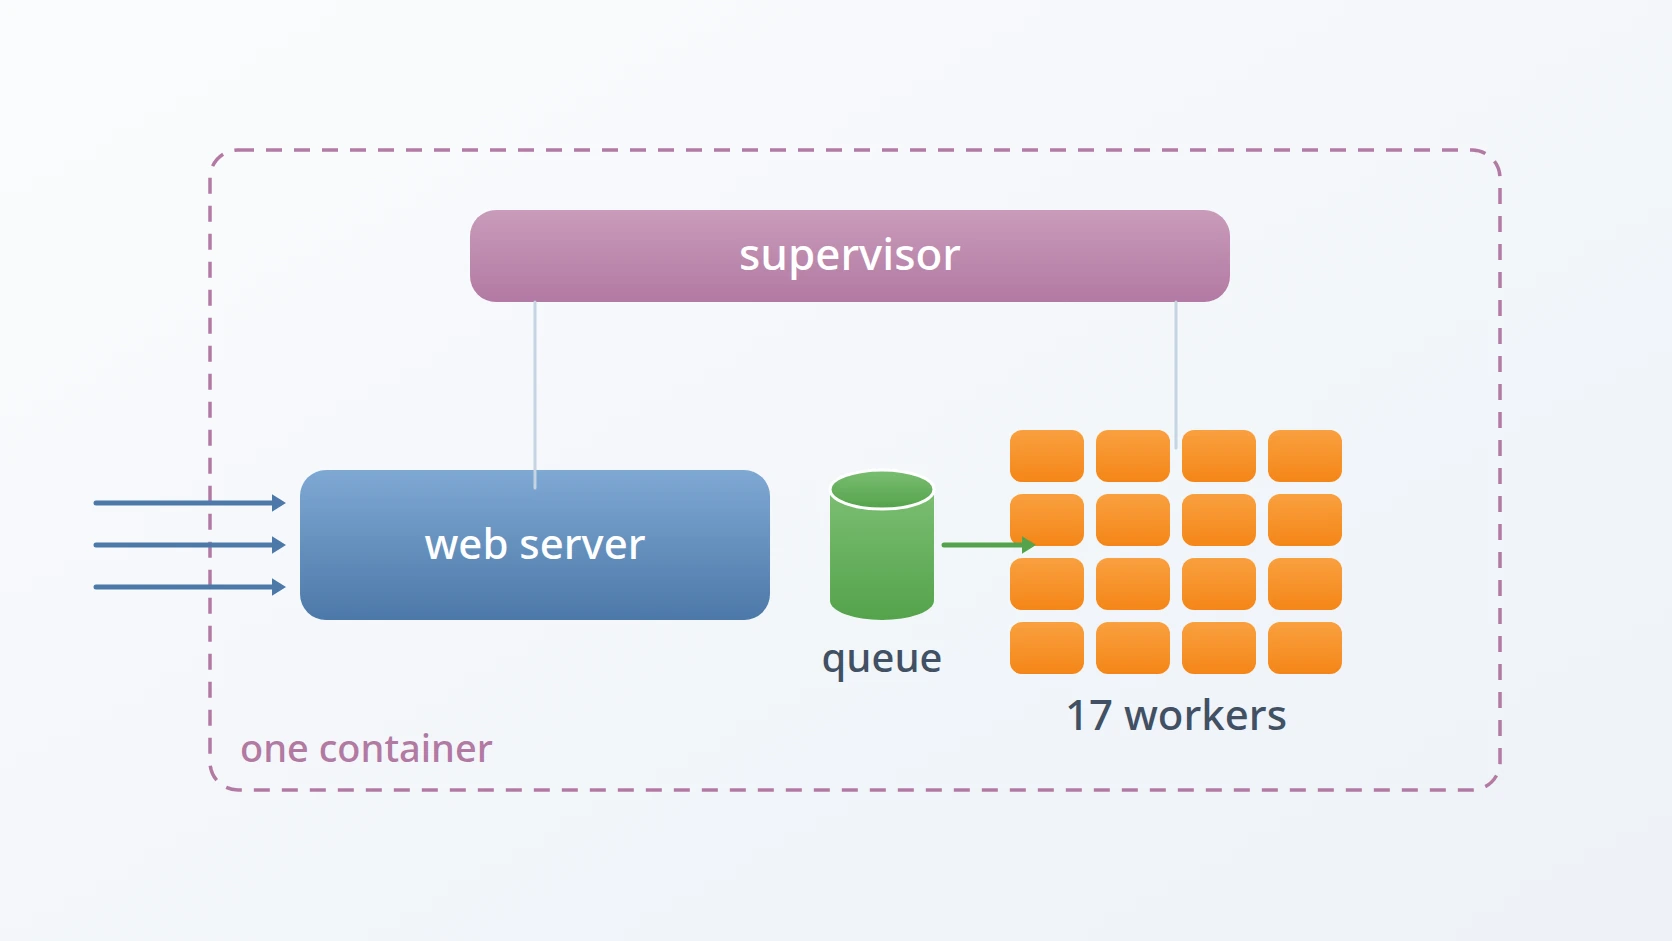
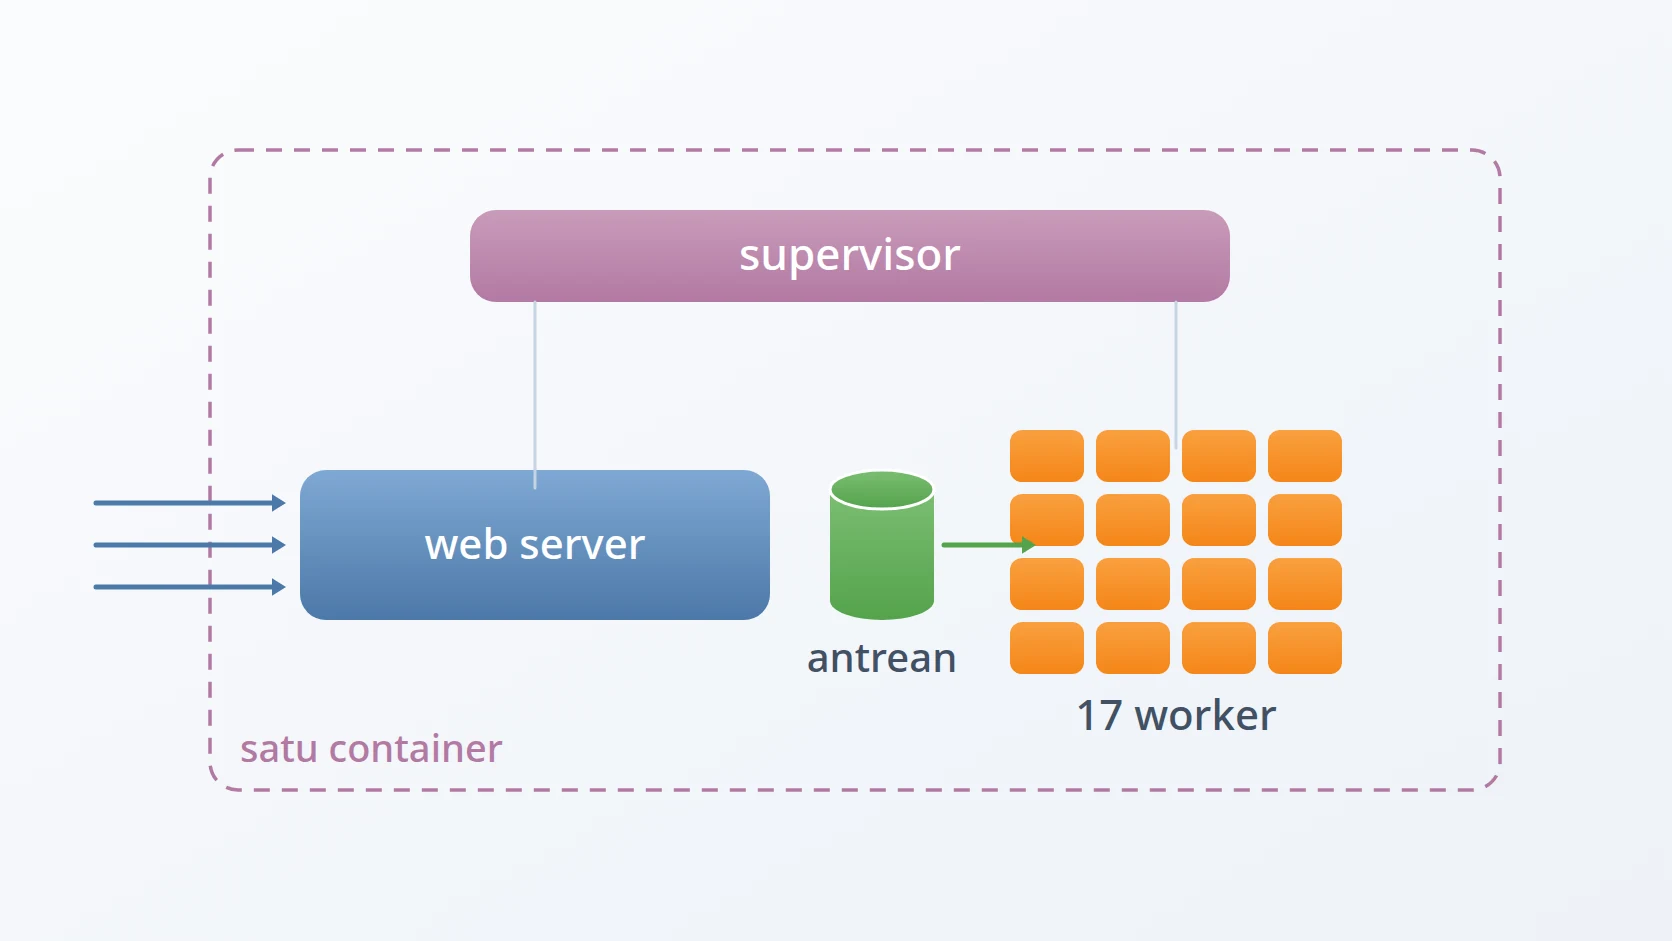
Proses pertama di container ini bukan web server, melainkan skrip pendek yang menyiapkan keadaan — hak akses, cache, pemeriksaan bahwa database terjangkau — lalu menggantikan dirinya sendiri dengan sebuah process manager. Manager itulah yang memegang tiga program: web server, tujuh belas worker antrean, dan satu pemantau kecil yang mengawasi tumpukan antrean. Sisa tulisan ini membahas susunan tersebut, proses bangun yang menghasilkannya, dan pertukaran yang sengaja diambilnya.
E. Lima hambatan yang menghalangi
Dinyatakan sebagai tujuan: saya ingin menjalankan satu aplikasi yang sekaligus menjawab request HTTP dan mengerjakan pekerjaan tertunda, dari satu image saja, dengan kedua paruhnya sungguh-sungguh diawasi — bukan sekadar sama-sama ada. Tanpa membangun kode yang sama dua kali, dan tanpa container melaporkan dirinya sehat sementara separuh isinya sudah mati.
Gampang dirumuskan, canggung dibangun. Ada lima hambatan yang menghalangi, dan tak semuanya berupa kegagalan — dua yang pertama batasan yang harus disiasati, tiga sisanya keputusan yang terlihat sewenang-wenang sampai alasannya dituliskan.
Hambatan pertama: model eksekusi PHP yang lazim membangun ulang dunianya tiap request. Framework di-boot, service provider didaftarkan, config dan route diurai, rangkaian dependency disusun — lalu response dikirim dan semuanya dibuang supaya request berikutnya membangunnya lagi. Untuk aplikasi seukuran apa pun, itulah sebagian besar waktu yang dihabiskan satu request yang sebenarnya cuma membaca satu baris lalu mengembalikan JSON. Alternatif yang ditolak adalah runtime PHP biasa yang jadi pilihan pertama semua orang; penggantinya worker mode, aplikasinya di-boot sekali lalu dipertahankan di memory antar request. Pilihan itu mengikat semua yang datang sesudahnya, dan karena itulah ia didahulukan.
Hambatan kedua: container mengandaikan satu proses, sementara aplikasi ini dua jenis proses berumur panjang sekaligus. Web server yang hidup lebih lama dari tiap request dan sekumpulan worker yang hidup lebih lama dari tiap job sama-sama proses yang enggan berakhir, tapi cara keduanya gagal berbeda, dan cara keduanya berhenti pun berbeda. Runtime container cuma sanggup mengawasi salah satunya. Kalau web server-nya sehat sementara seluruh worker antreannya mati, runtime tetap menyebut container itu sehat, sebab yang ia awasi memang masih berjalan. Alternatif yang ditolak adalah dua image terpisah — artinya membangun kode yang identik dua kali sambil menerima kenyataan bahwa kedua paruhnya cepat atau lambat akan menyimpang. Penggantinya: satu process manager memegang tiga program, sehingga pengawasannya pindah ke dalam container, bukan di atasnya.
Hambatan ketiga: jumlah worker tak bisa diturunkan dari jumlah inti. Tujuh belas proses di host enam belas inti terlihat seperti kekeliruan, dan memang akan keliru seandainya pekerjaannya komputasi — proses yang lebih banyak dari inti lazimnya tak membeli apa pun selain context switching. Pekerjaan ini bukan komputasi. Nyaris semuanya mengirim email, memanggil endpoint eksternal lalu menunggu jawabannya, atau membaca dan menulis file, dan proses yang terblokir di sebuah socket memegang slot proses tanpa memegang inti. Menyamakan jumlah worker dengan jumlah inti adalah alternatif yang ditolak, dan itu akan membiarkan mesinnya menganggur sementara antreannya menumpuk.
Hambatan keempat: dua batas waktu yang tinggal di dua file berbeda punya urutan yang merupakan syarat kebenaran. Yang satu milik worker dan menghentikannya sesudah sebuah job berjalan terlalu lama; yang lain milik antrean dan menentukan kapan job yang belum selesai boleh diambil orang lain. Setel keduanya sendiri-sendiri — hal paling wajar dilakukan, sebab keduanya dikonfigurasi di tempat terpisah — dan antreannya bisa menyerahkan job yang sama ke worker kedua sementara yang pertama masih mengerjakannya. Hubungan antar angkanya itulah intinya, bukan angkanya sendiri.
Hambatan kelima: urutan build menentukan apakah cache-nya berharga sama sekali. Image berupa tumpukan layer, sebuah layer dipakai ulang hanya bila instruksi dan masukannya tak berubah, dan satu layer yang berubah membatalkan seluruh layer sesudahnya. Menyusun instruksi menurut kenyamanan adalah alternatif yang saya tolak, dan itu membuang cache-nya tiap kali build. Menyusunnya dari yang paling jarang berubah ke yang paling sering — paket sistem, lalu dependency, lalu kode aplikasi — itulah yang membuat build ulang sesudah perubahan satu baris berongkos detik, bukan menit.
Urutannya soal ketergantungan, bukan tingkat keparahan. Dua yang pertama batasan: keduanya menentukan container ini boleh berwujud seperti apa, dan tak ada yang masuk akal sesudahnya tanpa keduanya. Yang ketiga, keempat, dan kelima keputusan penyetelan di dalam wujud itu — berapa banyak worker, bagaimana mereka menyerah, dan bagaimana semuanya dibangun. Tiga yang terakhir masing-masing akan jadi default yang wajar bila berdiri sendiri; yang membuatnya layak dituliskan justru karena dalam susunan ini, ketiga default-nya sama-sama keliru.
Metode
A. Kecepatan lebih dulu: kenapa runtime ini, bukan yang biasa
Inilah jawaban atas hambatan pertama, dan di atasnyalah empat sisanya dibangun.
Model eksekusi PHP yang klasik membangun ulang seluruh dunia pada tiap request. Framework di-boot, service provider didaftarkan, konfigurasi dan route diurai, rangkaian dependency disusun — lalu jawaban dikirim dan semuanya dibuang, supaya request berikutnya bisa membangunnya lagi. Pada framework sebesar apa pun, di situlah sebagian besar waktu habis, bahkan untuk request yang kerjanya cuma membaca satu baris dan mengembalikan JSON.
Worker mode meniadakan itu. Aplikasi di-boot sekali lalu ditahan di memori, dan tiap request dikerjakan di atas aplikasi yang sudah ter-boot. Runtime yang saya pilih FrankenPHP, yaitu runtime PHP yang menyatu ke dalam web server Caddy, dan ia mendukung cara kerja itu secara langsung. Alternatifnya sudah saya timbang dan saya tolak atas dasar yang sama: PHP-FPM klasik di balik web server terpisah tetap menanggung penuh ongkos boot per request, sedangkan OpenLiteSpeed memang lebih cepat daripada susunan seadanya, tapi ia masih memperlakukan aplikasi sebagai barang yang dimasuki ulang, bukan barang yang dijaga tetap hangat. Menjaga aplikasi tetap hangat itulah seluruh keuntungannya, dan itu sepadan dengan base image yang kurang familiar.
Yang menarik, konfigurasinya ternyata sedikit sekali. Tak ada Laravel Octane di daftar dependency project ini — tak ada paket, tak ada service provider, tak ada apa pun di sisi aplikasi. Worker mode cukup satu variabel environment.
# Mendengar di port biasa; nilai FRANKENPHP_CONFIG inilah yang menyalakan
# worker mode, menahan aplikasi tetap ter-boot di antara request.
Konfigurasi web server-nya pun setali tiga uang ringkasnya, dan sebagian besar isinya justru mematikan sesuatu.
{
    # HTTPS dituntaskan reverse proxy di depan container ini, jadi server
    # tak boleh berusaha mengurus sertifikatnya sendiri.
    auto_https off
    admin off
    frankenphp
}

:8000 {
    root * /app/public
    encode gzip
    php_server
    file_server
}
Kedua sakelar itu disengaja. Container ini tak pernah terjangkau dari internet; ada reverse proxy di depannya yang memegang sertifikat. Web server yang mencoba menerbitkan sertifikatnya sendiri akan gagal berulang-ulang dan berisik, untuk nama host yang bukan miliknya. Endpoint administrasi dimatikan dengan alasan yang sama seperti pintu dikunci: ia memungkinkan konfigurasi ulang saat berjalan, tak ada yang membutuhkannya dari dalam container, dan itu satu permukaan lebih sedikit yang perlu dipikirkan.
B. Entrypoint menyiapkan, lalu menyingkir
Entrypoint container ini berupa skrip shell, tapi ia tidak bertahan sebagai proses utama container. Tugasnya membawa aplikasi ke keadaan yang pasti, lalu menyerahkan peran PID 1 kepada pihak yang lebih pantas memegangnya.
# Database yang sesaat tak terjangkau tak boleh menggagalkan container.
||
&& &&
&& &&
# Minta worker sisa container sebelumnya menuntaskan job lalu berhenti.
# Gantikan shell ini dengan process manager, yang lalu menjadi PID 1.
Tiga keputusan dalam baris-baris itu pantas ditarik keluar.
Pemeriksaan database sengaja dibuat tak fatal. Ia melaporkan apakah database terjangkau lalu meneruskan langkah apa pun hasilnya. Sekilas ini terkesan ceroboh, padahal justru sebaliknya: container ini diatur restart otomatis, sehingga container yang menolak menyala gara-gara database tak terjangkau selama empat detik akan masuk ke lingkaran restart dan mengubah gangguan yang sembuh sendiri menjadi gangguan yang tidak. Aplikasinya toh akan gagal di pemeriksaan kesehatannya sendiri sampai database kembali, dan di situlah tempat yang benar bagi kegagalan itu untuk muncul.
Cache dibersihkan sebelum dibangun ulang. Cache konfigurasi dan route berupa file terkompilasi; image yang membawa cache basi dari waktu build akan menyajikan konfigurasi basi selamanya, sedangkan membersihkannya lebih dulu cuma memakan satu detik saat menyala.
Baris terakhir yang paling menentukan. exec menggantikan shell dengan process manager, bukan menjalankannya sebagai anak, sehingga manager itulah yang menjadi PID 1. Tanpa exec, shell tetap jadi PID 1 dengan manager di bawahnya, dan sinyal penghentian yang dikirim ke container akan mendarat di shell yang tak tahu harus berbuat apa — worker tak pernah diberi tahu untuk berhenti, lalu dibunuh paksa begitu tenggang waktunya habis. Satu kata kunci memisahkan penghentian yang tertib dari penghentian yang brutal.
C. Tiga program di bawah satu supervisor
Inilah jawaban atas hambatan kedua: saya memindahkan pengawasan ke dalam container, tempat ia sanggup melihat kedua paruhnya.
Process manager yang saya pilih adalah Supervisor, dan file konfigurasinya boleh dibilang dokumen desain paling jujur dari susunan ini. Ia mendeklarasikan tiga program, lengkap dengan kebijakan menyalakan, menyalakan ulang, dan menghentikan masing-masing.
[program:frankenphp]
command=frankenphp run --config /etc/caddy/Caddyfile
user=www-data
autostart=true
autorestart=true
priority=10
stdout_logfile=/dev/stdout
stdout_logfile_maxbytes=0
stderr_logfile=/dev/stderr
stderr_logfile_maxbytes=0
stopwaitsecs=10
priority menentukan urutan menyala, terkecil lebih dulu, sehingga web server sudah berjalan sebelum para worker mulai berebut database. autorestart adalah kebijakan restart yang tak lagi bisa disediakan runtime container, karena yang diawasinya kini process manager, bukan aplikasinya. Bila web server mati, Supervisor menyalakannya lagi dan container tak merasakan apa-apa.
Baris pencatatan log kelihatan sepele padahal menentukan. Kedua aliran diarahkan ke stdout dan stderr milik container, dengan ukuran rotasi nol yang berarti rotasi log bawaan Supervisor dimatikan sepenuhnya. Ini disengaja. Apa pun yang ditulis ke dua aliran itu dipungut runtime container, dan ke sanalah semua container lain di host ini sudah mengirim lognya. Membiarkan Supervisor memutar log ke file di dalam container berarti menaruhnya di tempat yang tak dipungut siapa pun dan tak dirotasi siapa pun, lalu diam-diam memenuhi disk.
stopwaitsecs adalah tenggang antara permintaan berhenti dan pembunuhan paksa. Sepuluh detik sudah longgar bagi web server, yang cukup menuntaskan request yang sedang berjalan. Angka itu jauh dari cukup bagi worker antrean, dan karena itulah mereka dikonfigurasi terpisah.
[program:laravel-queue]
command=php /app/artisan queue:work --sleep=3 --tries=3 --timeout=90 --max-jobs=100 --max-time=3600 --memory=512
user=www-data
autorestart=true
startretries=10
priority=20
numprocs=17
process_name=%(program_name)s_%(process_num)02d
stopwaitsecs=60
stopasgroup=true
killasgroup=true
numprocs=17 itulah baris yang membuat semuanya bekerja: satu deklarasi program menghasilkan tujuh belas proses mandiri, dibedakan pola penamaan bernomor di bawahnya. Supervisor mengawasi ketujuh belasnya satu per satu dan menyalakan ulang masing-masing sendiri-sendiri.
Perilaku berhenti inilah tempat perbedaan kedua jenis proses menjadi kasatmata. Enam puluh detik, bukan sepuluh, sebab worker yang diminta berhenti akan menuntaskan job yang sedang dipegangnya lebih dulu — dan job yang menandatangani dokumen tak pantas dipotong di titik sembarang. stopasgroup serta killasgroup ada karena worker tak selalu berupa proses tunggal: menjalankan job bisa memunculkan proses anak, dan memberi sinyal hanya kepada induknya akan meninggalkan anak yatim yang terus mengerjakan pekerjaan yang tak ditunggu siapa pun. Sinyalnya dikirim ke seluruh grup proses.
startretries=10 lebih tinggi daripada tiga milik web server, dengan alasan yang sama seperti pemeriksaan database yang tak fatal. Worker yang tak bisa menjangkau database langsung gagal seketika, jadi gangguan sesaat menghabiskan jatah percobaan jauh lebih cepat ketimbang pada server yang baru gagal ketika ada request masuk.
D. Kenapa tujuh belas worker di mesin enam belas inti
Inilah jawaban atas hambatan ketiga, dan ia layak diargumentasikan, bukan sekadar dinyatakan.
Penalaran itu berlaku untuk pekerjaan yang memakai inti. Pekerjaan di sini tidak. Dari dua puluh satu jenis pekerjaan tertunda di aplikasi ini, sebagian besarnya mengirim email, memanggil endpoint HTTP di luar lalu menunggu jawabannya, atau membaca dan menulis file. Proses yang sedang melakukan itu bukan sedang menghitung — ia terhenti, menunggu socket atau disk, memegang slot proses tanpa memegang inti. Menakar jumlah worker dari jumlah inti justru membiarkan mesin menganggur sementara enam belas prosesnya sama-sama menunggu server orang lain.
Maka saya menakar jumlahnya dari perkiraan seberapa banyak yang menunggu bersamaan, bukan dari inti, dengan batas memori sebagai pagar yang sebenarnya: tiap worker dibatasi 512 MB dan berhenti sendiri bila melewatinya, sehingga kemungkinan terburuknya masih sanggup ditanggung host. Tujuh belas adalah penilaian atas bentuk beban kerja ini, bukan optimum hasil pengukuran. Sejauh ini nyaman dipakai, dan inilah angka yang paling mungkin berubah bila komposisi pekerjaannya berubah — penandatanganan dokumen benar-benar memakan CPU, dan seandainya ia berubah dari kasus langka menjadi kasus umum, angka ini harus diturunkan.
Dua flag menjaga kolam worker tetap sehat sepanjang waktu. --max-jobs=100 dan --max-time=3600 membuat tiap worker berhenti sesudah seratus job atau satu jam, mana yang lebih dulu tercapai, lalu Supervisor segera menyalakan penggantinya. Ini pemanfaatan kebijakan restart yang disengaja: proses PHP berumur panjang menumpuk memori yang tak pernah benar-benar dilepasnya, dan ketimbang memburu tiap kebocoran, worker-nya didaur ulang cukup sering sehingga kebocoran itu tak pernah sempat berarti.
# Kolamnya dibatasi memory, bukan inti, dan didaur ulang dengan sengaja.
--max-jobs=100 \ # daur ulang sesudah 100 job...
--max-time=3600 \ # ...atau satu jam, mana yang lebih dulu
--timeout=90 # lihat seksi berikutnya: angka ini tak gratis
E. Dua batas waktu yang urutannya tak boleh terbalik
Inilah jawaban atas hambatan keempat, dan angkanya jauh kurang penting ketimbang hubungan di antara keduanya.
Job yang menggantung harus akhirnya dilepaskan, kalau tidak satu worker akan memeluknya selamanya dan kolam worker menyusut satu tiap kali kejadian itu berulang. Ada dua mekanisme terpisah yang menanganinya, keduanya tinggal di file berbeda, dan hubungan antar angkanya merupakan syarat kebenaran, bukan sekadar selera.
Yang pertama batas milik worker sendiri, --timeout=90 dari konfigurasi di atas. Worker yang sudah menghabiskan sembilan puluh detik pada satu job akan menghentikan dirinya. Ini ditegakkan lewat sinyal alarm dari ekstensi pcntl, dan itulah sebabnya ekstensi tersebut ikut dipasang saat membangun image.
# pcntl yang membuat --timeout bisa ditegakkan; tanpanya job yang
# menggantung tak pernah dipotong dan worker-nya tak pernah kembali.
Mekanisme kedua milik antreannya sendiri, dan ia ada justru karena mekanisme pertama tak bisa diandalkan sendirian. Bila worker mati mendadak — container dihentikan, mesin kehilangan daya — tak ada yang sempat mengembalikan job-nya. Maka antrean mencatat kapan job itu diserahkan, dan sesudah retry_after detik ia menganggap job itu telantar lalu menyediakannya kembali.
Kedua angka itu harus berurutan, dan urutannya bukan asal pilih. retry_after mesti lebih besar daripada timeout worker. Bayangkan bila keduanya sama: pada detik kesembilan puluh worker mulai menghentikan job-nya, dan pada detik kesembilan puluh yang sama persis antrean memutuskan job itu telantar lalu menawarkannya ke worker lain. Job yang sama pun berjalan dua kali secara bersamaan, selagi salinan pertamanya masih dalam proses berhenti. Untuk email, artinya user menerimanya dua kali. Untuk tanda tangan dokumen, artinya jauh lebih runyam.
Memberi retry_after nilai yang lebih besar menutup celah itu: worker selalu kebagian waktu untuk menuntaskan proses berhentinya, dan melepas job itu sendiri, sebelum antrean bersedia menyerahkannya kepada siapa pun. Selisih kedua angka itulah margin keamanannya.
Ada satu akibat yang perlu dinyatakan terang-terangan, sebab mudah terlewat saat membaca kelas-kelas job. Tak satu pun dari dua puluh satu kelas itu menyatakan timeout-nya sendiri, jadi sepasang angka ini mengatur seluruh jenis pekerjaan tertunda di aplikasi. Menaikkan timeout demi satu job yang lambat berarti menaikkannya untuk semua, sekaligus menaikkan nilai di antreannya. Itu batasan yang sebaiknya diketahui sebelum menambahkan job yang memakan dua menit.
F. Menyusun urutan build supaya cache-nya benar-benar menolong
Inilah jawaban atas hambatan kelima, dan satu-satunya yang hasilnya diukur dalam menit, bukan dalam benar-salah.
Bila diurutkan menurut seberapa sering benar-benar berubah, aplikasi ini punya tiga kelompok: paket sistem dan ekstensi PHP, yang berubah mungkin dua kali setahun; dependency PHP, yang berubah bila ada paket ditambah atau dinaikkan versinya; dan kode aplikasi, yang berubah berkali-kali sehari. Maka saya meletakkan ekstensi pertama, dependency kedua, dan kode paling akhir.
Dependency butuh satu akal tambahan, sebab memasangnya secara normal menuntut kode aplikasi sudah ada — dan itu justru mementahkan seluruh urutannya. Tahap build terpisah yang menyelesaikannya.
# Tahap satu: dependency saja. Tak ada yang bergantung pada kode aplikasi,
# jadi layer ini dipakai ulang sampai file lock-nya sendiri berubah.
# Tahap dua, sesudah layer ekstensi yang berat: ambil dependency jadi dari
# tahap satu, baru salin kode aplikasi PALING AKHIR.
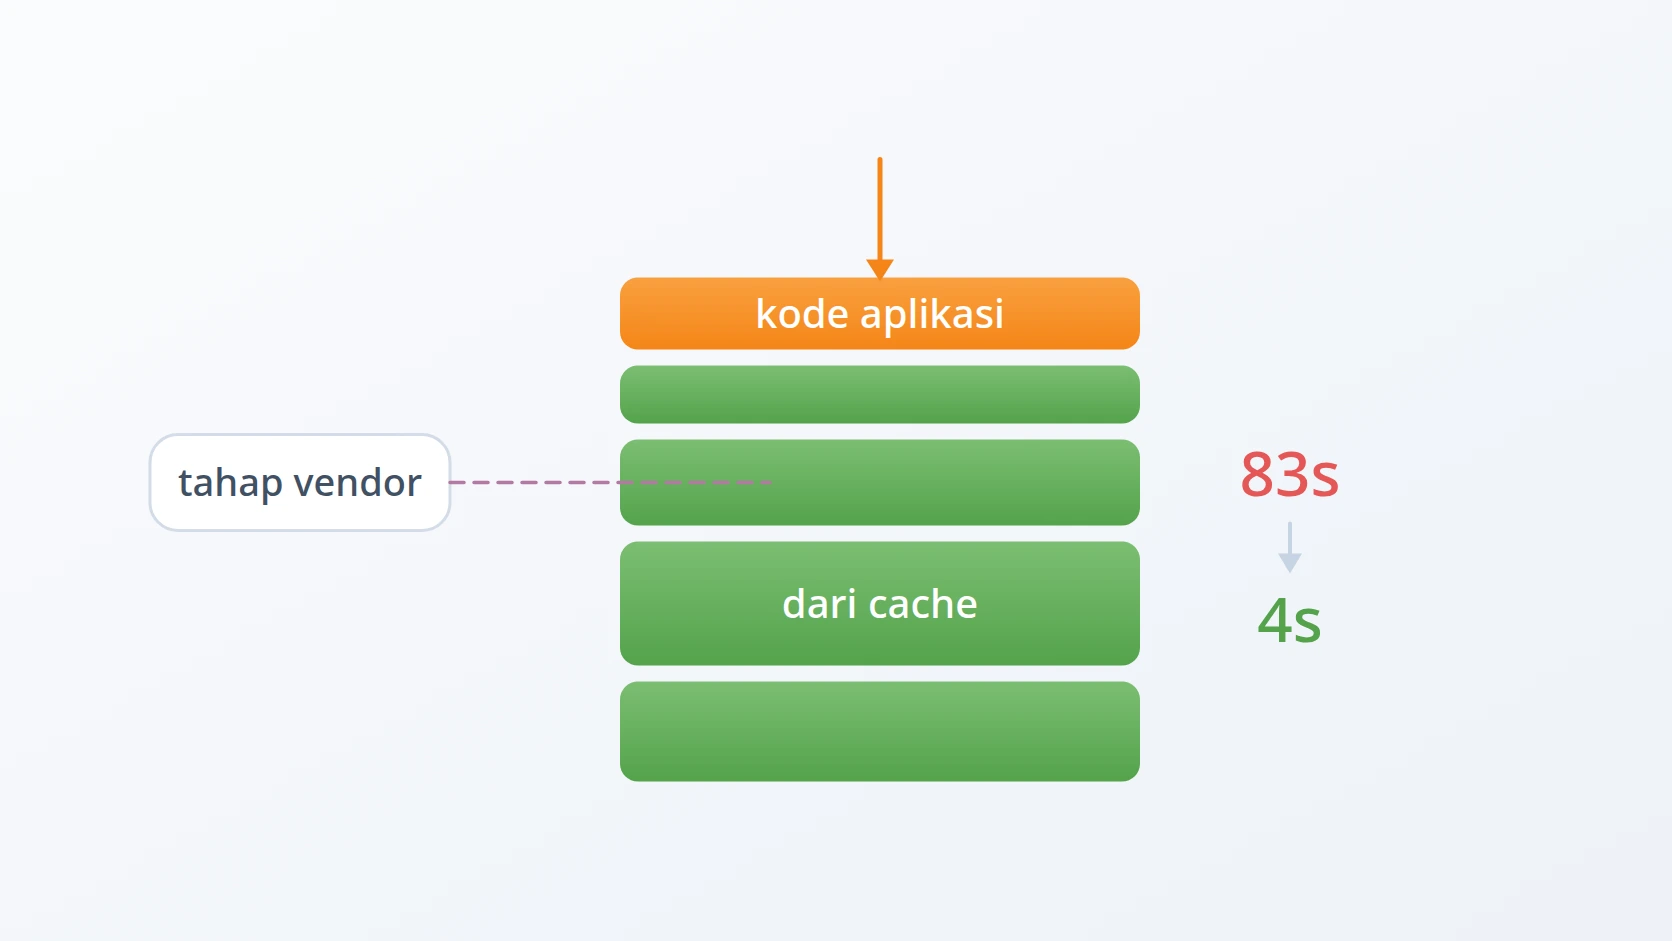
Tahap pertama hanya menyalin dua file manifes dependency lalu memasang dari keduanya, dengan script dan pembuatan autoloader dimatikan karena keduanya menuntut kode aplikasi yang memang sengaja belum ada. Tahap kedua menyalin hasil jadinya, baru sesudah itu memasukkan kode, lalu membuat autoloader teroptimasi sekali ketika semuanya sudah lengkap.
Satu baris di file pengecualian bersifat menahan beban, bukan sekadar merapikan. Proses build mengecualikan vendor dari penyalinan direktori kerja, dan itu penting karena COPY . . jika tidak akan menimpa dependency hasil tahap pertama dengan apa pun yang kebetulan ada di mesin yang menjalankan build. Begitulah dependency khusus pengembangan bisa menyelinap ke image production, dan itu perkara yang sukar disadari belakangan.
Penanganan kepemilikan file adalah optimasi yang lebih kecil dengan efek yang besar. Menetapkan kepemilikan sambil menyalin itu gratis, sedangkan mengubah kepemilikan secara rekursif ke seluruh aplikasi sesudahnya menjadi layer tersendiri yang menulis ulang tiap file — lambat saat dibangun, dan melipatduakan ruang yang ditempati file-file itu di dalam image.
Hasil dan Pembahasan
A. Seberapa berharga urutan build tadi
Saya memakai urutan di atas untuk menggantikan proses bangun lama yang menyalin semuanya lebih dulu lalu memasang dependency belakangan. Selisihnya tampak pada satu-satunya tindakan yang dilakukan terus-menerus — mengubah sebaris kode aplikasi lalu membangun ulang.
| Perubahan yang dilakukan | Sebelum | Sesudah |
|---|---|---|
| Kode aplikasi saja | ~83 d | ~4 d |
| Dependency ditambah atau dinaikkan | ~83 d | ~83 d |
| Ekstensi PHP ditambah | ~83 d | bangun penuh |
Baris kedua dan ketiga sama pentingnya dengan yang pertama. Tak ada yang dibuat lebih cepat secara umum; pekerjaannya cuma dipindahkan sehingga kasus yang terjadi lima puluh kali sehari jadi murah, sementara kasus yang terjadi dua kali setahun tidak. Perubahan dependency tetap membayar ongkos penuh, dan memang seharusnya begitu, sebab layer yang memuat dependency sungguh-sungguh harus dibangun ulang.
Proses bangun yang bergantung pada keberadaan folder dependency di mesin yang menjalankannya membuat isi image mengikuti apa pun yang kebetulan terpasang di laptop seorang pengembang. Proses bangun bertahap menurunkannya dari file lock, sehingga commit yang sama menghasilkan image yang sama di mana pun — dan justru itulah yang membuat pembangunan otomatis pada tiap push menjadi mungkin sama sekali.
B. File sepuluh megabita yang bisa lenyap tanpa pesan error
Satu akibat dari base image ini layak dicatat, karena tak ada jejaknya di log mana pun.
Image FrankenPHP tidak membawa file konfigurasi PHP sama sekali. Bukan file kosong — memang tak ada, sehingga yang berlaku adalah nilai bawaan yang tertanam di PHP: batas dua megabita untuk file yang diunggah dan delapan megabita untuk badan request. Reverse proxy di depan container mengizinkan dua puluh megabita, dan aplikasinya ditulis dengan anggapan itu.
Bila dibiarkan, file berukuran antara dua dan dua puluh megabita lolos dari proxy, sampai ke PHP, lalu dibuang sebelum aplikasi sempat melihatnya. Larik unggahan berisi kode error "melebihi batas" dengan nama file sementara yang kosong, dan validasi framework melaporkannya sebagai field yang tidak valid. User diberi tahu dokumennya tidak diterima. Log mencatat kegagalan validasi. Tak ada satu pun yang menyebut soal batas ukuran, sebab sejauh yang diketahui aplikasi, ia memang cuma menerima field yang rusak.
PDF sepuluh megabita yang dikirim ke endpoint penandatanganan dokumen akan gagal tanpa keterangan apa pun selain nama field-nya. Penangkalnya dua baris.
; Base image tak membawa php.ini sama sekali, jadi tanpa file ini nilai
; bawaan PHP (2M unggahan, 8M badan) membuang diam-diam yang lebih besar.
upload_max_filesize = 20M
post_max_size = 20M
Keduanya sengaja disetel dua puluh megabita, menyamai proxy persis, bukan melampauinya. Alasannya soal komponen mana yang gagal lebih dulu: ketika batasnya sama, proxy menolak request kebesaran dengan kode status yang jelas sebelum PHP terlibat. Andai batas PHP lebih tinggi, proxy tetap menolaknya; andai batas PHP lebih rendah, kegagalannya kembali membisu. Menyamakan angkanya membuat perilakunya bisa diramalkan, dan hal semacam ini sebaiknya tertulis di dalam image ketimbang diingat-ingat.
C. Wujud container ini dilihat dari luar
Dari sudut pandang host, container ini tetap satu kesatuan, dan deklarasinya biasa saja — justru itu maksudnya.
ports:
- ${API_PORT}:8000 # diikat ke satu alamat gateway, bukan 0.0.0.0
restart: always
healthcheck:
test:
interval: 30s
start_period: 40s
extra_hosts:
# Arahkan penyedia identitas ke host, supaya panggilan antar-server
# dari container tetap berada di dalam mesin.
- "<sso-host>:${GATEWAY_IP}"Dua hal pantas ditarik keluar. Port yang dipublikasikan diikat ke satu alamat gateway tertentu, bukan ke semua antarmuka, sehingga container ini terjangkau dari proxy dan tidak dari yang lain. Lalu pemetaan host itu ada karena aplikasi melakukan panggilan antar-server ke penyedia identitas yang nama publiknya, bila diakses dari luar, mengarah ke jaringan pengirim konten yang menjawab klien otomatis dengan halaman tantangan, bukan dengan token. Memetakan nama itu ke alamat host sendiri membuat panggilan tersebut tetap internal, tempat ia dijawab sebagaimana mestinya.
Tenggang awal adalah bagian yang mengakui semua yang dibahas di atas: container diberi empat puluh detik sebelum kesehatannya mulai dinilai, sebab entrypoint-nya membersihkan cache, membangunnya ulang, lalu menyalakan delapan belas proses sebelum ada yang sanggup menjawab.
Simpulan
Dua jenis proses berumur panjang kini berjalan dalam satu container karena saya menaruh process manager di posisi yang biasanya diisi aplikasi, dan kesehatan container ditentukan oleh manager itu, bukan oleh satu program mana pun. Proses bangun yang menghasilkan image-nya disusun menurut seberapa sering tiap bagian berubah, dan itulah yang membuat susunan ini enak dikerjakan sehari-hari.
Yang didapat dari sini adalah kepaduan. Satu image berarti web server dan para worker pasti memakai kode, dependency, dan konfigurasi yang sama karena konstruksinya memang begitu, bukan karena kesepakatan. Ada satu nomor versi yang perlu dipikirkan, satu benda yang di-deploy, dan satu aliran log tempat request beserta job yang diantrekannya muncul berurutan.
Harganya adalah penskalaan yang tak bisa berdiri sendiri. Worker tak mungkin ditambah tanpa ikut menyalakan ulang web server, sebab keduanya satu container. Mengubah tujuh belas menjadi dua puluh lima berarti restart yang memutus koneksi, dan itu tukar-tambah yang buruk kalau yang sedang tertekan cuma antreannya. Seandainya keduanya kelak perlu diskalakan pada jadwal yang berbeda, susunan ini jadi keliru dan sebaiknya dipecah — image-nya sendiri sudah mendukung, sebab cukup menjalankan image yang sama dengan perintah berbeda.
Di samping pemeriksaan kesehatan, pemantau tumpukan antrean berjalan berdampingan dengan para worker dan meningkatkan peringatan bila antrean melewati ambang, sehingga pool yang menyusut tampak sebagai antrean yang terus membesar — sinyal yang penting ketika pertanyaannya adalah apakah pekerjaannya benar-benar dikerjakan.
Bagian yang bisa dibawa ke luar PHP adalah asas pengurutannya. Proses dipisahkan menurut berapa lama ia hidup dan bagaimana ia harus dihentikan, bukan menurut bahasa pemrogramannya atau tim yang memilikinya. Web server dan worker antrean berbeda justru pada yang menentukan — yang satu boleh dipotong, yang satu tidak — dan begitu perbedaan itu dituliskan sebagai konfigurasi, susunannya menjelaskan dirinya sendiri.
Istilah
- Queue
- Daftar pekerjaan yang menunggu dikerjakan belakangan. Di sini berupa tabel database, jadi satu butir pekerjaan sama dengan satu baris.
- Job
- Satu butir di dalam queue: catatan yang menyebut kode mana yang dijalankan dan dengan data apa.
- Worker antrean
- Proses berumur panjang yang berulang kali mengambil job berikutnya dari queue, mengerjakannya, lalu meminta job lagi.
- Worker mode
- Cara menjalankan aplikasi PHP dengan mem-boot framework sekali lalu memakainya ulang untuk banyak request, bukan membangunnya ulang tiap kali. Tak ada kaitannya dengan worker antrean meski katanya sama.
- PID 1
- Proses pertama yang dijalankan di dalam container. Begitu ia berhenti, container ikut berhenti, dan ia pula yang menerima sinyal permintaan berhenti.
- Process manager
- Program yang tugas satu-satunya menyalakan program lain, mengawasinya, dan menyalakannya kembali bila gagal. Di sini yang dipakai Supervisor.
- Reverse proxy
- Server di depan aplikasi yang menerima request dari luar lalu meneruskannya ke dalam, umumnya sekaligus menuntaskan HTTPS sehingga aplikasi di belakangnya cukup berbicara HTTP biasa.
- Layer
- Hasil satu instruksi dalam proses bangun image. Sebuah image berupa tumpukan layer.
- Build cache
- Pemakaian ulang layer yang sudah pernah dibangun selama instruksi dan masukannya tak berubah. Layer yang berubah membatalkan seluruh layer sesudahnya.
- Multi-stage build
- Satu file build yang memuat beberapa proses bangun terpisah, di mana tahap belakangan menyalin file pilihan dari tahap sebelumnya dan membuang sisanya.
- retry_after
- Berapa lama antrean menunggu sebelum menganggap job yang sudah diserahkan itu telantar lalu menawarkannya lagi. Wajib lebih besar daripada timeout milik worker.
Technologies covered
- PHP
- Laravel
- Docker
- FrankenPHP
- nginx
- Supervisor

