Bagaimana Saya Menyiapkan Stack Logs, Traces, dan Metrics untuk Project Baru dengan Satu Perintah
On this page
- Pendahuluan
- A. Apa isi stack-nya
- B. Kenapa satu stack per project, dan kenapa "menampilkan" termasuk syarat selesai
- C. Jalan pintas yang saya tolak
- D. Enam hambatan yang menghalangi
- Metode
- A. Membuat direktori data sebelum Docker membuatnya
- B. Membiarkan satu node sehat di disk kecil
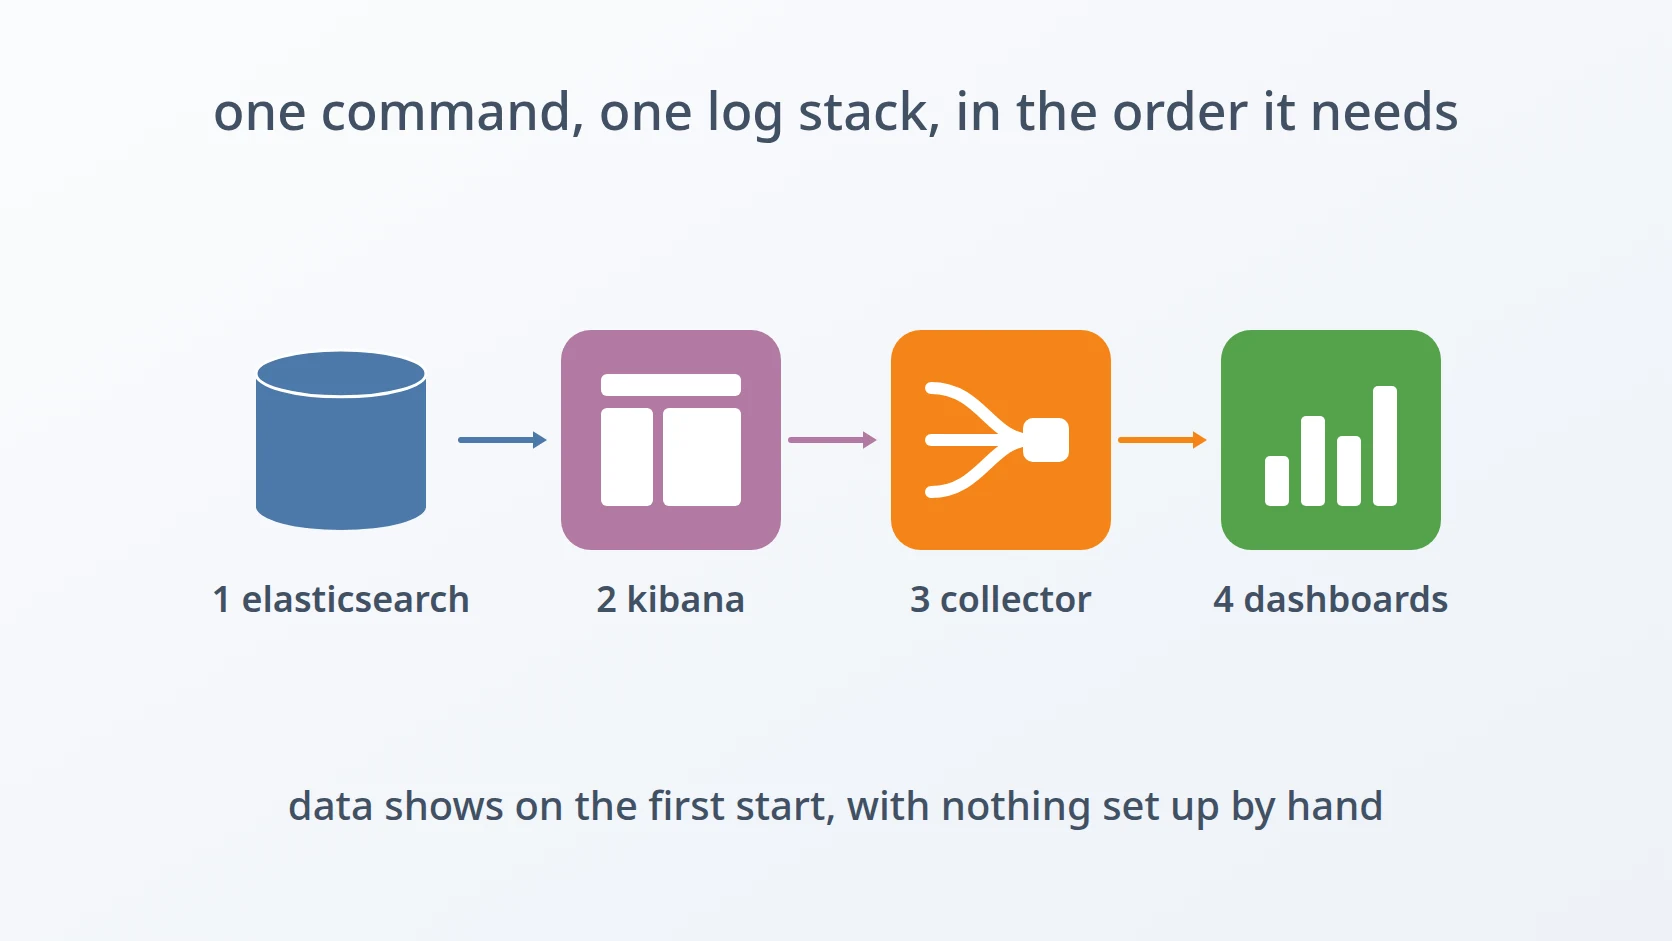
- C. Menyalakan sesuai urutan yang dibutuhkan service
- D. Nol replica tanpa kehilangan mapping resmi
- E. Collector yang hanya bisa menulis datanya sendiri
- F. Data view sebelum dashboard
- Hasil dan Pembahasan
- A. Apa yang dihasilkan satu perintah
- B. Menjalankannya tanpa orang di depan keyboard
- C. Di mana ini berhenti
- Simpulan
- Istilah
Pendahuluan
Setiap project yang saya jalankan di production butuh tempat untuk menampung logs, traces, dan metrics-nya, sekaligus cara untuk melihat semuanya ketika ada yang salah. Saya ingin tempat itu tersedia untuk project baru cukup dengan satu perintah: stack yang menerima telemetry begitu ia menyala, dan yang sudah menampilkannya di dashboard saat pertama kali saya membukanya, tanpa satu klik pun di antarmuka untuk menyiapkan apa-apa.
A. Apa isi stack-nya
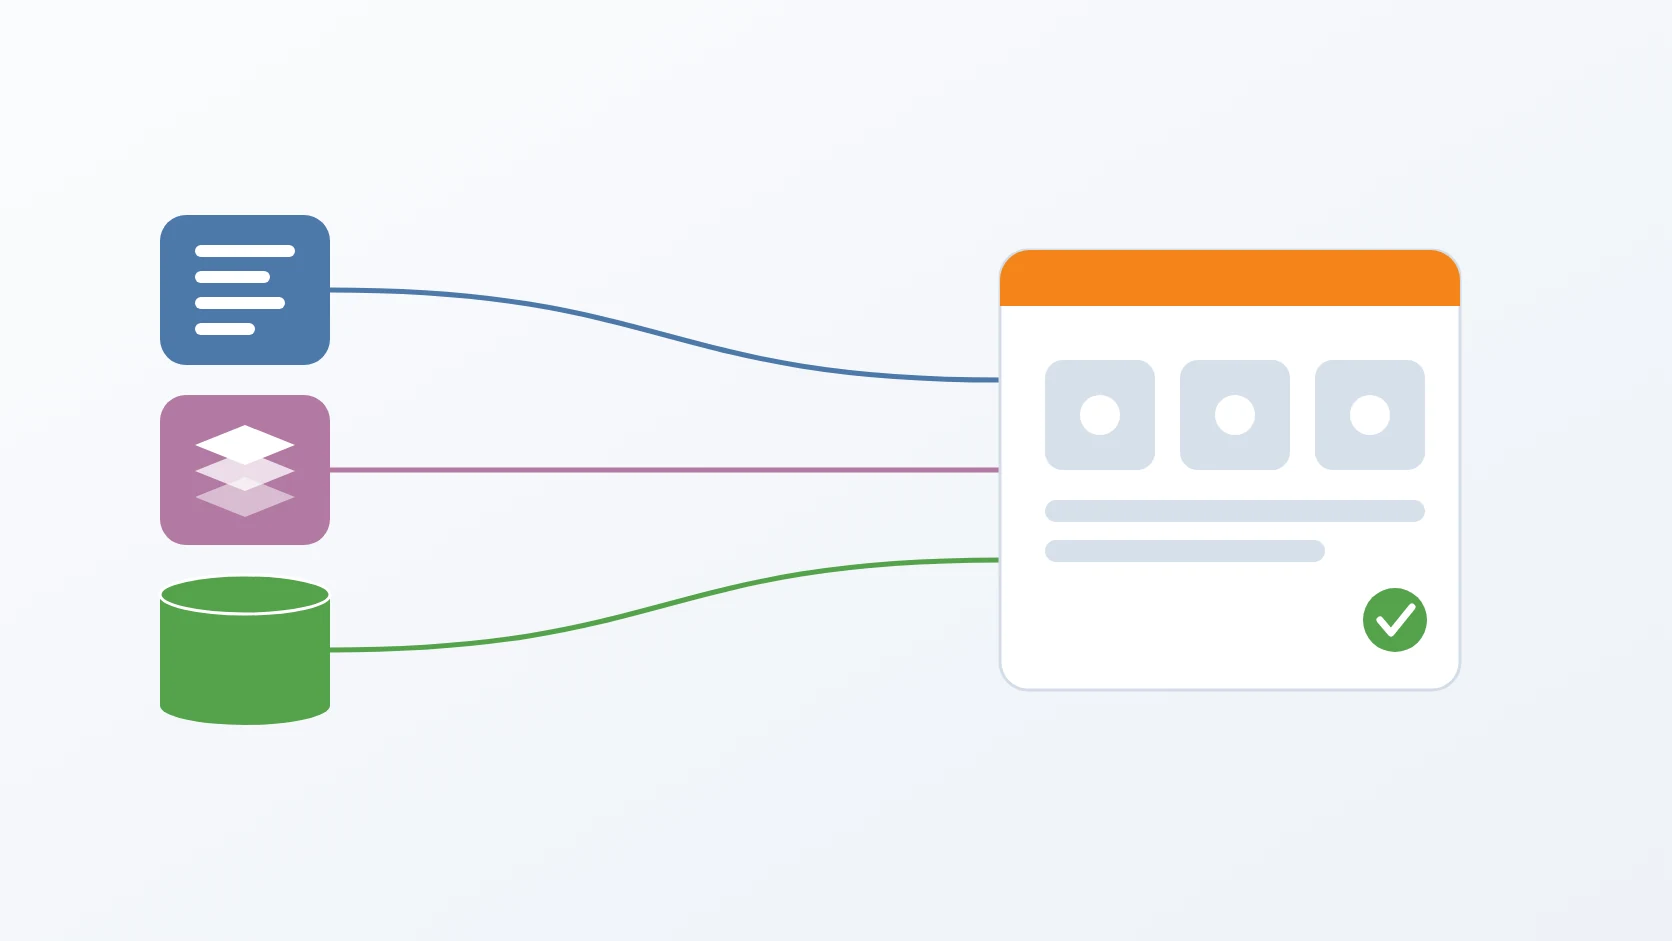
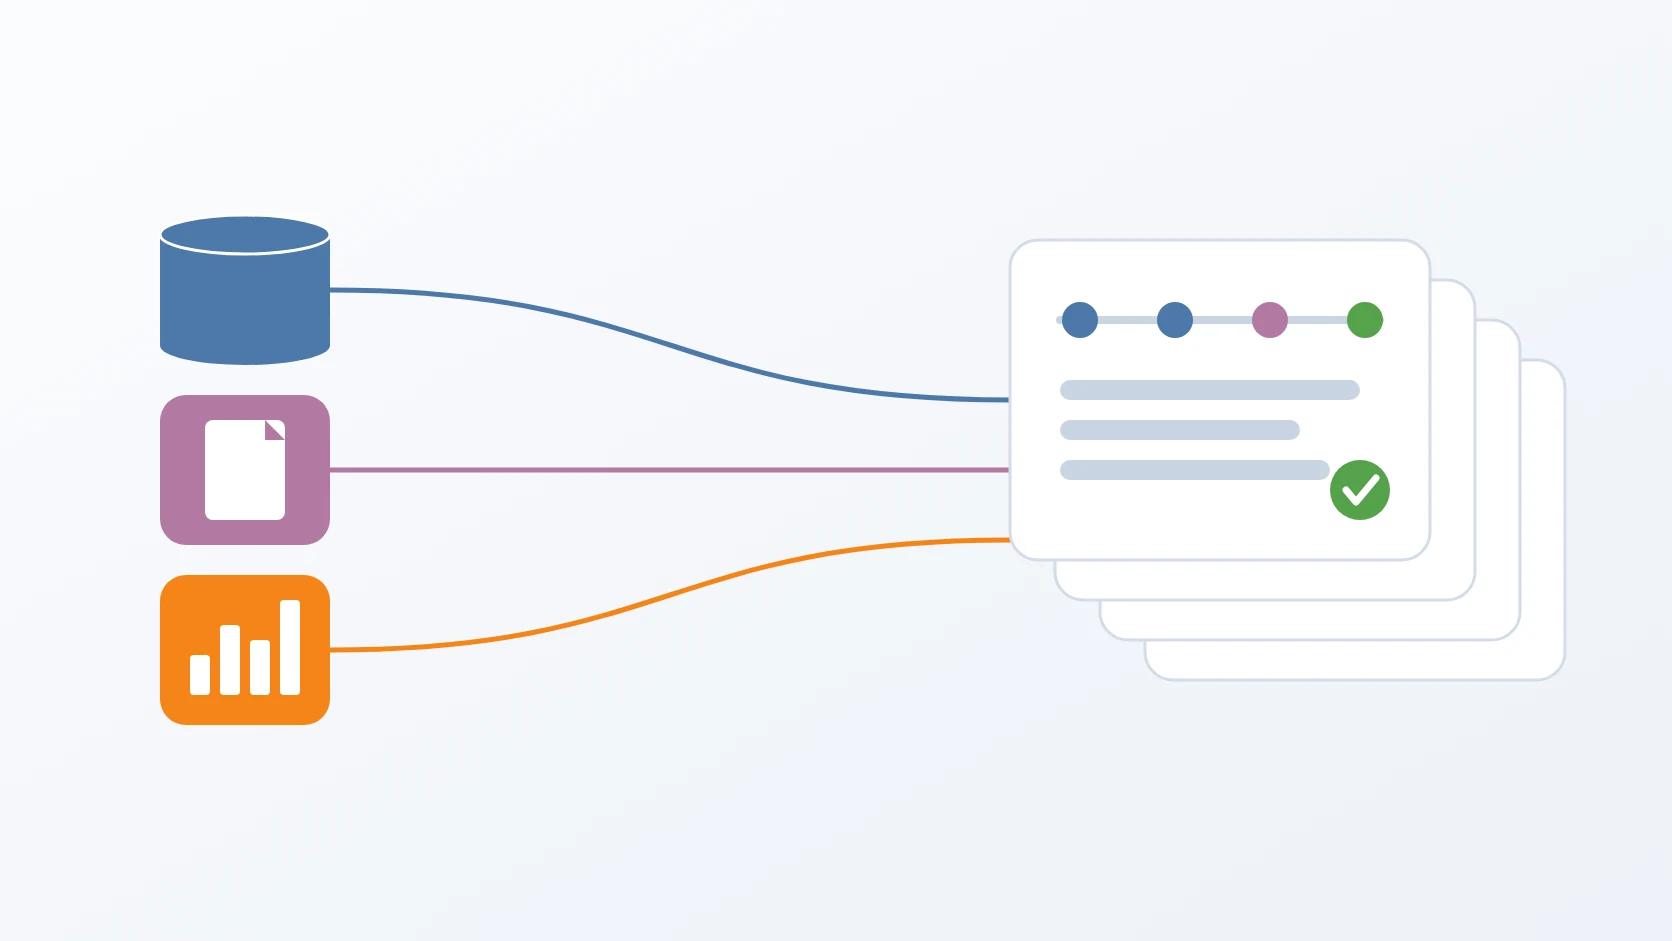
Stack ini terdiri dari tiga bagian. OpenTelemetry Collector menerima telemetry dari setiap service di project itu lewat OTLP, protokol standar milik proyek OpenTelemetry, di satu port untuk gRPC dan satu port untuk HTTP. Elasticsearch menyimpan apa yang diteruskan collector dalam tiga keluarga data stream: satu untuk logs, satu untuk traces, dan satu untuk metrics. Kibana membaca Elasticsearch lalu menampilkannya, lewat data view yang memberi tahu Kibana data stream mana yang harus dibaca, dan dashboard yang dibangun di atas data view itu.
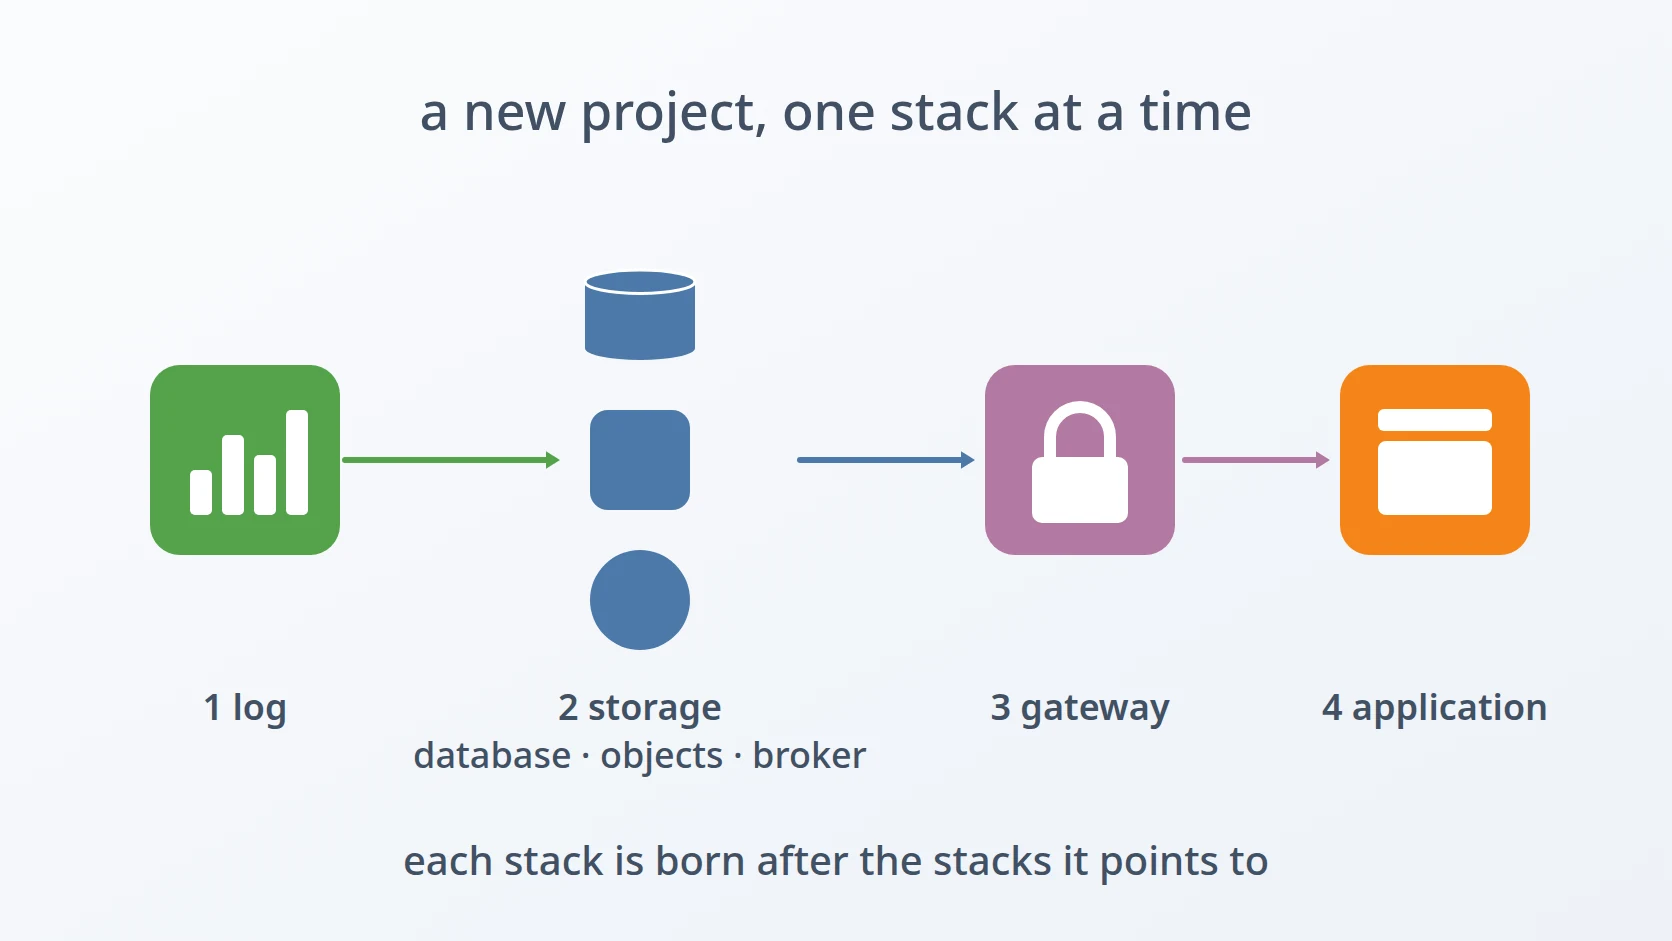
Setiap bagian bergantung pada bagian lain dengan cara yang spesifik. Collector tak bisa mengirim apa pun sampai Elasticsearch mau menerima tulisannya, dan ia butuh user yang memang diizinkan menulis. Kibana tak bisa start sampai ia bisa login ke Elasticsearch dengan akun bawaannya sendiri. Dan Elasticsearch, ternyata, tak bisa menerima pengaturan yang benar untuk data milik collector sampai Kibana pernah start setidaknya sekali. Stack yang ketergantungannya dipenuhi dengan tangan hanya bisa diandalkan sejauh tangan yang memenuhinya.
B. Kenapa satu stack per project, dan kenapa "menampilkan" termasuk syarat selesai
Setiap project mendapat stack sendiri, bukan stack bersama. Log dari sistem satu klien tak pernah berada di database yang sama dengan log klien lain, satu project bisa dipindah ke server lain beserta telemetry-nya, dan project yang bermasalah hanya bisa memenuhi disknya sendiri, bukan disk semua orang. Ongkos pemisahan itu adalah stack harus dibuat berkali-kali, dan justru itulah yang membuat generator layak ditulis.
Sejak awal saya juga memutuskan bahwa "stack-nya jalan" berarti lebih dari "container-nya healthy". Collector yang menerima data sementara Elasticsearch diam-diam menolaknya, atau Elasticsearch yang penuh data tapi Kibana tak punya view untuknya, sama-sama lolos health check dan sama-sama membuat saya buta tepat ketika saya perlu melihat. Definisi selesainya: trace yang dikirim satu service muncul di dashboard, dan generator harus mencapai keadaan itu tanpa campur tangan saya.
Definisi itu juga mengubah cara kegagalan disadari. Kalau dashboard baru dibangun ketika ada yang membutuhkannya, saat pertama orang menyadari telemetry tak pernah sampai adalah saat insiden, momen paling buruk untuk mulai men-debug alat debugging itu sendiri. Stack yang menampilkan data sejak menit pertamanya mengubah dashboard yang kosong menjadi persoalan yang jelas terlihat di hari project disiapkan, ketika belum ada apa pun yang bergantung padanya.
C. Jalan pintas yang saya tolak
Jalan pintas pertama adalah satu stack log bersama untuk semua project. Ongkos menjalankannya lebih murah, tapi data para klien jadi tercampur, retensi dan pemakaian disk setiap project jadi urusan semua project, dan matinya satu stack berarti hilangnya penglihatan di mana-mana. Jalan itu saya tolak dengan alasan yang sama seperti alasan saya memisahkan project-project itu sendiri.
Jalan pintas kedua adalah menyalakan container lalu menyiapkan sisanya di antarmuka Kibana: membuat data view, menyusun dashboard, menambahkan user untuk collector. Cara itu berhasil sekali. Cara itu juga tak terdokumentasi, sedikit berbeda setiap kali dikerjakan, dan mustahil diulang persis di project berikutnya. Jalan pintas ketiga adalah menyalin folder stack milik project terakhir. Salinan itu membawa nama-nama project sebelumnya ke project baru — di role, user, template, dan nama container — dan stack log yang menulis atas nama project lain lebih buruk daripada tak punya stack sama sekali, karena ia tampak benar.
Yang tersisa adalah template tempat setiap nama khas project berupa placeholder, dan generator yang mengisi placeholder itu, menyiapkan host, menyalakan container dalam urutan yang mereka butuhkan, lalu menjalankan setiap langkah setup lewat API yang semestinya dipanggil antarmuka.
D. Enam hambatan yang menghalangi
Gampang dirumuskan, canggung dibangun. Ada enam rintangan di antara template dan stack yang menampilkan data sejak start pertamanya.
Direktori data dibuat oleh user yang salah. Ketika direktori bind mount belum ada, Docker membuatnya, sebagai root. Elasticsearch berjalan sebagai user biasa di dalam container-nya, tak bisa menulis ke direktori milik root, lalu gagal start dengan error soal mendapatkan node lock. Membiarkan Docker yang membuat direktori itu adalah alternatif yang ditolak; hasilnya gagal setiap kali, dan hanya di host yang masih bersih.
Host berdisk sesak membuat cluster tak pernah sehat. Elasticsearch berhenti menempatkan data begitu disk-nya melewati ambang watermark, jadi di server lab dengan sedikit ruang kosong, single node tak pernah mencapai green atau yellow, health check-nya tak pernah lolos, dan setiap langkah yang menunggunya ikut menunggu selamanya. Mempertahankan watermark bawaan adalah alternatif yang ditolak, karena watermark itu ada untuk melindungi replica di cluster multi-node yang tak dimiliki stack ini.
Tiga service harus start dalam urutan yang tak ditegakkan satu pun dari mereka. Kibana butuh password-nya sudah diset di Elasticsearch sebelum bisa start. Index template milik collector dibangun di atas pengaturan yang hanya diregistrasi Kibana, jadi menyiapkan Elasticsearch sebelum Kibana siap pasti gagal. Menyalakan semuanya sekaligus lalu menyiapkannya belakangan adalah alternatif yang ditolak, karena setiap langkah bergantung pada langkah lain yang harus sudah selesai.
Single node butuh nol replica, tanpa kehilangan mapping telemetry resmi. Replica tak bisa tinggal di node yang sama dengan primary-nya, jadi setiap index di satu node tetap yellow kecuali replica-nya diset nol. Template penangkap-semua yang menyetel nol replica untuk segalanya ikut menggantikan mapping resmi OpenTelemetry, dan Elasticsearch lalu menolak metrics dengan document_parsing_exception: dynamic template 'gauge_long' not found. Template penangkap-semua itulah alternatif yang ditolak.
Collector tak boleh menulis sebagai superuser. Memberikan password administrator bawaan ke collector adalah alternatif yang ditolak: komponen yang tugasnya cuma menambahkan telemetry jadi bisa menghapus index, mengubah pengaturan keamanan, atau membaca segalanya. Ia butuh user sendiri dan role yang dibatasi ke data stream miliknya, dibuat oleh generator yang sama, setiap kali.
Dashboard menunjuk data view lewat identifier. Dashboard yang disimpan di file merujuk data view yang dibacanya lewat identifier, jadi meng-import dashboard sebelum data view itu ada, atau ke data view yang dibuat dengan identifier acak, meninggalkan panel yang tak menampilkan apa pun. Membuat data view dengan tangan di antarmuka adalah alternatif yang ditolak.
Urutannya mengikuti perjalanan hidup stack. Hambatan pertama ditemui saat host disiapkan, yang kedua saat Elasticsearch pertama kali menyala, yang ketiga saat service-service menyala satu per satu, yang keempat dan kelima saat stack disiapkan untuk menerima data pertamanya, dan yang keenam saat ia disiapkan untuk menampilkannya.
Metode
A. Membuat direktori data sebelum Docker membuatnya
Inilah jawaban atas hambatan pertama: generator membuat direktori data sendiri, sebagai user yang menjalankannya, sebelum container mana pun menyala. Docker lalu menemukan direktori itu sudah ada dan membiarkan kepemilikannya. Di mesin-mesin saya, user itu biasanya punya id numerik yang sama dengan user di dalam container Elasticsearch, jadi database bisa menulis ke sana.
Path-nya berawalan prefix karena setiap stack di server saya menyimpan datanya di bawah satu direktori teratas, disusun mengikuti folder tempat stack itu dijalankan. File compose me-mount path berprefix itu, jadi generator harus membuat direktorinya di sana, bukan di dalam folder stack. Membuatnya di folder stack akan tampak benar, padahal titik mount sebenarnya tetap diserahkan ke Docker, dan ke root.
B. Membiarkan satu node sehat di disk kecil
Template mematikan disk watermark untuk cluster single node ini, dengan komentar yang menyebut alasannya: node lab tak boleh terblokir hanya karena disk host sesak, kalau tidak cluster tak pernah green atau yellow dan health check yang ditunggu semua langkah lain tak pernah lolos.
log.elasticsearch:
  environment:
    - discovery.type=single-node
    - cluster.routing.allocation.disk.threshold_enabled=false
Harganya, tak ada yang mencegah Elasticsearch memenuhi disk, jadi retensi tiap data stream, bukan watermark, yang menjaga disk agar tak kehabisan ruang.
C. Menyalakan sesuai urutan yang dibutuhkan service
Saya membuat generator tak mengandalkan service-service itu untuk saling menunggu. Ia menyalakan semuanya, lalu menyusuri ketergantungannya satu per satu secara eksplisit. Collector satu-satunya service yang bisa menyatakan ketergantungannya di file compose, jadi itulah yang ia lakukan: ia baru start sesudah Elasticsearch melapor healthy.
log.otel-collector:
  depends_on:
    log.elasticsearch:
      condition: service_healthy
Begitu Elasticsearch healthy, generator mengeset password akun bawaan Kibana, karena Kibana tak bisa start tanpanya. Lalu ia menunggu sampai Kibana melapor available. Lalu ia menunggu sekali lagi, untuk satu component template tertentu yang diregistrasi Kibana saat start pertamanya. Index template milik collector disusun dari komponen bawaan semacam itu, dan meminta Elasticsearch membuat index template yang komponennya belum ada akan gagal dengan error 400 yang menyebut komponen yang hilang.
for; do
code=""
&& break
Penantian kedua itu ada karena status available dari Kibana ternyata belum berarti komponen-komponennya sudah terpasang; kadang komponen itu baru muncul beberapa detik kemudian. Menunggu persis barang yang dibutuhkan, bukan status yang biasanya menyiratkan barang itu sudah ada, menghapus kegagalan acak terakhir dari proses setup. Baru sesudah itu generator membuat index template, dan baru sesudah template-template itu ada ia membangun data view dan meng-import dashboard.
D. Nol replica tanpa kehilangan mapping resmi
Pengaturan replica kini tinggal di satu component template kecil miliknya sendiri. Template penangkap-semua yang lama dihapus bila versi sebelumnya meninggalkannya, dan tiga index template, satu per sinyal, masing-masing disusun dari komponen resmi OpenTelemetry ditambah satu komponen itu. Setiap data stream mendapat nol replica, dan tak satu pun kehilangan mapping resminya.
PUT _component_template/__SLUG__-otel-replicas
PUT _index_template/__SLUG__-logs-otel
Menyusun, bukan menimpa, itulah yang membuatnya aman diperbarui: ketika Elasticsearch membawa komponen resmi baru, template ikut memakainya, dan tambahan saya tetap satu pengaturan saja.
E. Collector yang hanya bisa menulis datanya sendiri
Script setup membuat role yang izin index-nya hanya mencakup pola data stream milik collector, dan user yang hanya memegang role itu. Collector login dengan user tersebut; password superuser hanya dipakai script setup dan tak pernah sampai ke konfigurasi collector.
Setiap definisi di proses setup ditulis utuh — template dan role dengan PUT, template penangkap-semua yang lama dihapus hanya bila ada, data view dibuat hanya bila belum ada — jadi menjalankannya lagi membiarkan setiap objek seperti semula, bukan membuat duplikat. Karena itu aman dijalankan ulang sesudah gagal di tengah jalan, dan aman dijalankan pada stack yang sudah ada untuk memperbaruinya. Data stream yang dibuat sebelum template diperbaiki tetap memakai pengaturan lamanya sampai ia di-rollover, jadi script punya opsi untuk me-rollover-nya dengan sengaja.
F. Data view sebelum dashboard
Data view dibuat dengan identifier tetap, masing-masing dilewati bila sudah ada, dan baru sesudah itu dashboard di-import dari file yang disimpan bersama template, yang merujuk ke identifier tersebut. Meng-import dengan overwrite menyala membuat langkah ini idempoten seperti langkah lainnya: menjalankannya lagi mengganti setiap dashboard dengan dashboard yang sama, bukan menambah salinan.
Hasil dan Pembahasan
A. Apa yang dihasilkan satu perintah
Satu kali jalan, generator menanyakan nama project, network Docker — apakah sudah ada, subnet-nya bila harus dibuat, dan alamat untuk binding port — username collector, dan tiga password — untuk superuser, untuk user collector, dan untuk akun Kibana — lalu menulis satu folder berisi file compose, konfigurasi collector, file environment, dan script-script setup. Bila diminta, ia juga menyalakan stack dan menuntaskan setup: index template, role dan user collector, tiga data view, serta empat dashboard untuk audit forensik, error dan reliabilitas, performa dan traffic, serta kesehatan service.
Telemetry pertama yang dikirim service mana pun sudah terlihat di dashboard tanpa ada yang dikonfigurasi dengan tangan. Setiap objek yang dibuat stack ini membawa nama project-nya: template menamai semuanya dengan placeholder dalam bentuk huruf kecil dan huruf besar, generator me-rename file yang membawanya lalu mengganti keduanya dalam satu kali jalan, dan identifier-nya sendiri adalah nama project bergaya domain dengan titik dan tanda hubung diubah menjadi garis bawah, jadi my-project.example.com menjadi my_project_example_com.
for; do
|| continue
base=""
done
| B. Menjalankannya tanpa orang di depan keyboard
Seperti generator saya yang lain, setiap pertanyaan bisa dijawab lewat environment variable bernama sama, dan satu variable melewati semua konfirmasi, jadi script yang sama melayani setup interaktif maupun tes otomatis untuk generator itu sendiri. Alamat binding port dibaca dari deskripsi network milik Docker sendiri, bukan dihitung dari subnet.
PROJECT=my-project.example.com NETWORK=my-project.net \
C. Di mana ini berhenti
Stack ini sengaja kecil. Elasticsearch berjalan sebagai single node, dan itulah sebabnya pengaturan replica dan disk di atas ada. Lalu lintas di antara service tetap di network Docker internal lewat HTTP polos dengan autentikasi, bukan TLS. Dan image collector tak punya shell, jadi ia tak bisa menjalankan health check di dalam container-nya sendiri; endpoint health-nya tetap tersedia untuk di-probe dari luar. Project yang sudah melampaui satu node butuh rancangan lain, bukan versi lebih besar dari rancangan ini.
Simpulan
Generator ini mengubah stack log dari rakitan tangan menjadi bekal yang diterima project baru lewat satu perintah, dan sudah sanggup menampilkan trace pertamanya. Sebagian besar kerjanya bukan di container-nya, melainkan di sekelilingnya: membuat direktori sebelum Docker sempat membuatnya dengan keliru, membiarkan satu node sehat di disk kecil, menyusuri urutan start yang tak ditegakkan satu pun service, memberi data nol replica tanpa kehilangan mapping resmi, memberi collector hak yang persis dibutuhkannya, tak lebih, dan membangun data view sebelum dashboard yang menunjuk ke sana. Masing-masing kini ditulis sekali, di generator, bukan diingat-ingat di setiap project baru.
Istilah
- OpenTelemetry
- Standar terbuka beserta seperangkat tools untuk menghasilkan dan mengumpulkan logs, traces, dan metrics dari aplikasi.
- OTLP
- Protokol OpenTelemetry, dipakai service untuk mengirim telemetry ke collector lewat gRPC atau HTTP.
- Collector
- Service yang menerima telemetry dari banyak sumber, mengolahnya, lalu meneruskannya ke storage.
- Data stream
- Rangkaian index di Elasticsearch yang hanya bisa ditambah, dipakai untuk data berurutan waktu seperti log.
- Index template
- Pengaturan dan mapping field yang diterapkan Elasticsearch ke setiap index baru yang namanya cocok dengan satu pola.
- Component template
- Potongan pengaturan atau mapping yang bisa dipakai ulang, tempat index template disusun.
- Data view
- Definisi di Kibana yang menyebut index atau data stream mana yang dibaca, dipakai dashboard dan pencarian.
- Bind mount
- Direktori di host yang dibuat tersedia di dalam container pada path tertentu.
- uid
- Identifier user berupa angka yang dipakai sistem operasi untuk menentukan siapa pemilik satu file.
Technologies covered
- Bash
- Elasticsearch
- Docker Compose
- Kibana
- OpenTelemetry