Bagaimana Saya Menentukan Tempat Tiap Potong Pekerjaan GPU
On this page
- Pendahuluan
- A. GPU kecil, GPU pinjaman, dan GPU milik orang lain
- B. Tiga tempat, dan tuntutan masing-masing
- C. Tujuh hambatan yang menghalangi
- Metode
- A. Angka sebagai pengganti perasaan
- B. Memecah project menjadi potongan
- C. Pergi karena keandalan, bukan karena memori
- D. Pergi karena metodenya berganti
- E. Pulang tanpa mengandaikan GPU
- F. Pulang seharusnya menghapus mesin
- G. Yang tetap di luar pun bisa dilucuti
- Hasil dan Pembahasan
- A. Hasil dari tujuh keputusan
- B. Dua pertanyaan, bukan satu
- C. Yang tidak dicakup
- Simpulan
- Istilah
Pendahuluan
A. GPU kecil, GPU pinjaman, dan GPU milik orang lain
Laptop saya punya GPU NVIDIA dengan video memory 4 GB. Video memory, atau VRAM, adalah tempat model harus berada selama GPU menjalankannya: bobot model, buffer kerja, dan apa pun yang dibutuhkan input saat itu. Kalau totalnya tak muat, model tidak lantas berjalan lebih lambat — model itu tidak jalan sama sekali, atau jatuh ke CPU dengan kecepatan yang membuatnya tak ada gunanya. Empat gigabyte cukup untuk banyak pekerjaan sehari-hari, tapi tidak cukup untuk kebanyakan model yang ingin saya pakai.
Jadi untuk beberapa waktu, jawaban atas tiap pekerjaan berat selalu sama: kirim ke Google Colab. Runtime Colab adalah virtual machine yang dipinjamkan selama satu sesi, dan yang saya pakai datang dengan GPU T4 ber-VRAM kira-kira 15 GB. Empat project akhirnya dibangun di sekitar mesin pinjaman itu. Yang pertama mengubah bab-bab tulisan menjadi video slideshow bernarasi: ia membuat gambar untuk tiap momen cerita, suara untuk tiap baris narasi, lalu merakit semuanya menjadi video. Yang kedua mengonversi dokumen PDF ke Markdown. Yang ketiga mentranskripsi rekaman menjadi subtitle. Yang keempat mengedit gambar. Keempatnya seharusnya program lokal biasa, dan keempatnya dibuat berjalan di Colab karena 4 GB tak sanggup memuat modelnya.
Bekerja di mesin pinjaman membawa konsekuensi yang jauh melampaui GPU-nya sendiri. Runtime berakhir bersama sesinya, jadi semua data yang dipegangnya harus disimpan di tempat yang bisa dijangkau kedua mesin. Laptop tak bisa memanggil runtime secara langsung, jadi perintah harus lewat message broker. Runtime bisa mati di tengah pekerjaan, jadi pekerjaannya harus bisa dilanjutkan dari titik terakhir. Tiap kebutuhan itu berubah menjadi mesin tambahan: object storage bersama, broker dengan identitas dan aturan aksesnya sendiri, logika resume, dan kontrak antara dua codebase yang tak pernah berbagi proses. Semuanya bekerja. Semuanya juga harus dirawat, dan tiap bagiannya ada hanya karena pekerjaannya berada di tempat lain.
Ada tempat ketiga untuk pekerjaan, dan tempat ini baru jadi pilihan serius belakangan: layanan yang di-hosting pihak lain. Di sini saya tidak menjalankan model sama sekali. Pekerjaannya dikirim ke model orang lain lewat API, lalu hasilnya kembali. Tak ada GPU saya yang terlibat, entah milik sendiri entah pinjaman. Yang dilepas adalah kendali atas metode: modelnya milik mereka, begitu pula perilaku dan batasnya.
Tantangannya adalah menentukan tempat tiap potong pekerjaan GPU — laptop dengan 4 GB-nya, runtime Colab pinjaman, atau layanan ter-hosting — berdasarkan kriteria dan bukan kebiasaan, serta membiarkan jawabannya berubah ketika kriterianya berubah.
Gampang dirumuskan, canggung dijalankan. Kebiasaan itu kuat justru karena dulu benar: ketika tak ada yang muat di laptop, semuanya pergi ke Colab, dan tiap project berikutnya meniru bentuk project pertama. Melepas kebiasaan itu berarti mengajukan pertanyaan yang sama untuk tiap potong pekerjaan, menerima kenyataan bahwa satu project bisa tersebar di tiga tempat, dan bersedia membongkar mesin yang dibangun berminggu-minggu begitu alasannya hilang.
B. Tiga tempat, dan tuntutan masing-masing
Ketiga tempat itu tidak bisa saling menggantikan, dan membandingkannya lebih mudah kalau tuntutan masing-masing disebut dulu. Laptop tidak menuntut apa-apa: file ada di disk, program saling memanggil langsung, dan kegagalan muncul di layar di depan mata. Batasnya cuma satu, yaitu batas yang memulai semua ini — VRAM 4096 MiB, ditambah kemampuan CPU laptop ketika GPU tak bisa dipakai.
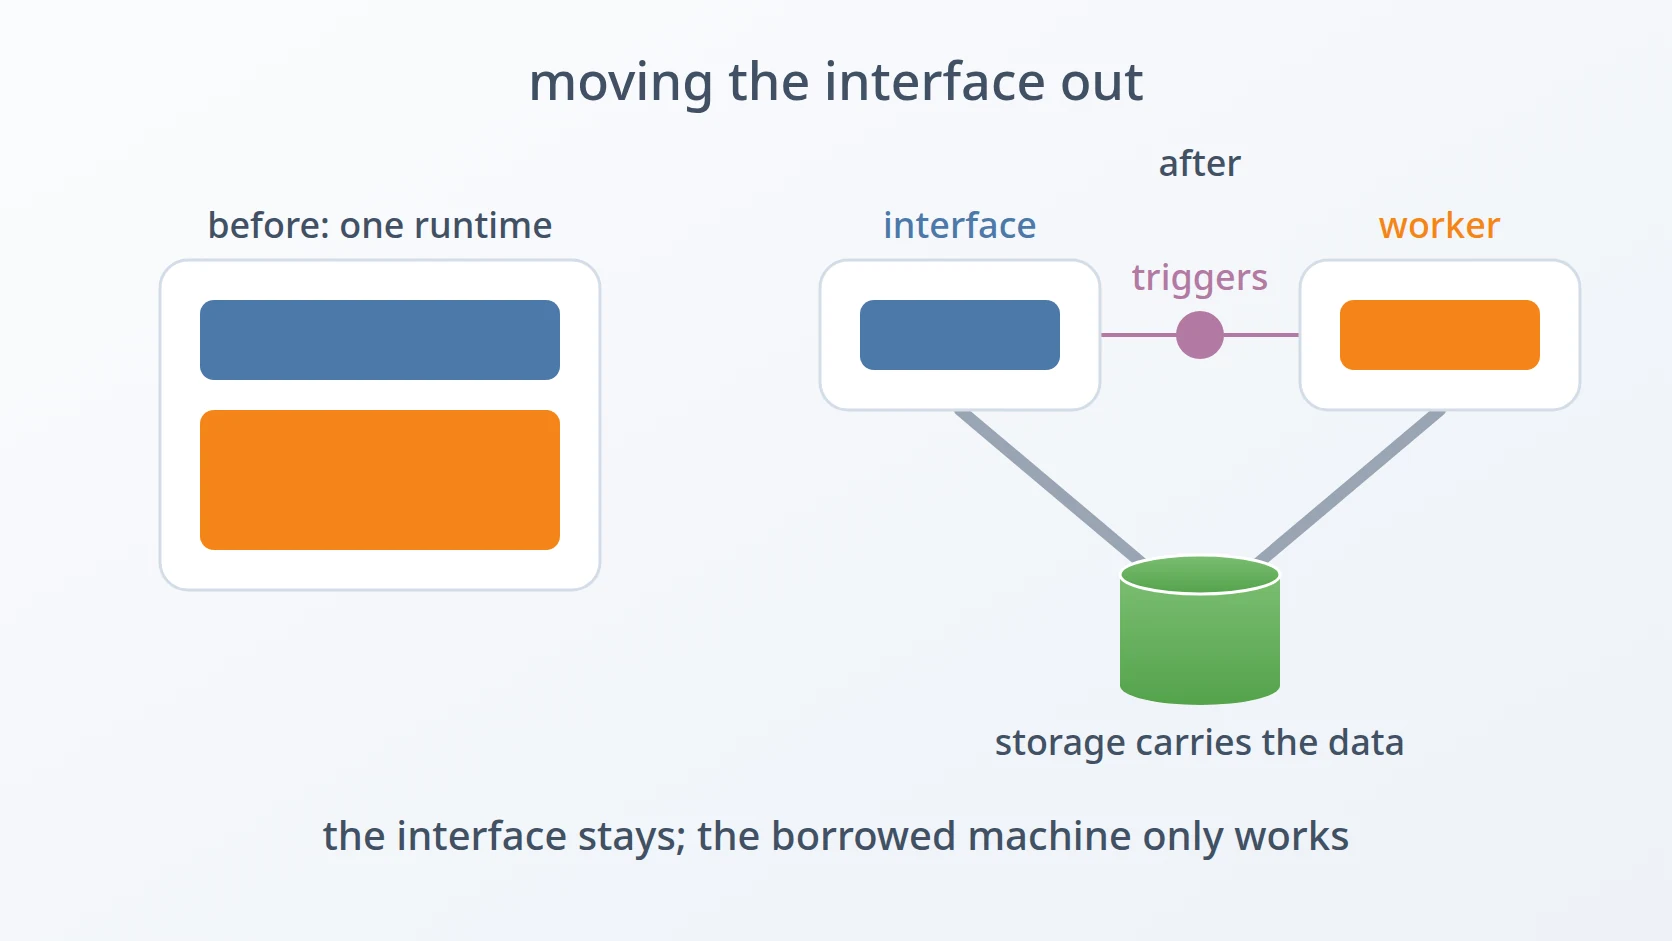
Colab menawarkan GPU hampir empat kali lebih besar, dan menuntut seluruh mesin tambahan tadi: storage yang terjangkau dua pihak, jalur untuk perintah, ketahanan terhadap runtime yang tiba-tiba hilang, serta antarmuka yang tinggal di luar runtime supaya tidak ikut hilang. Colab juga datang dengan batas yang tidak saya tentukan: panjang sesi, kuota GPU harian, dan aturan tentang untuk apa runtime boleh dipakai.
Layanan ter-hosting menuntut mesin tambahan paling sedikit — cukup kredensial dan request — tapi mengambil kendali paling banyak. Mutu keluaran, setelan yang boleh diatur, dan perilaku model saat menerima input yang janggal semuanya milik penyedia.
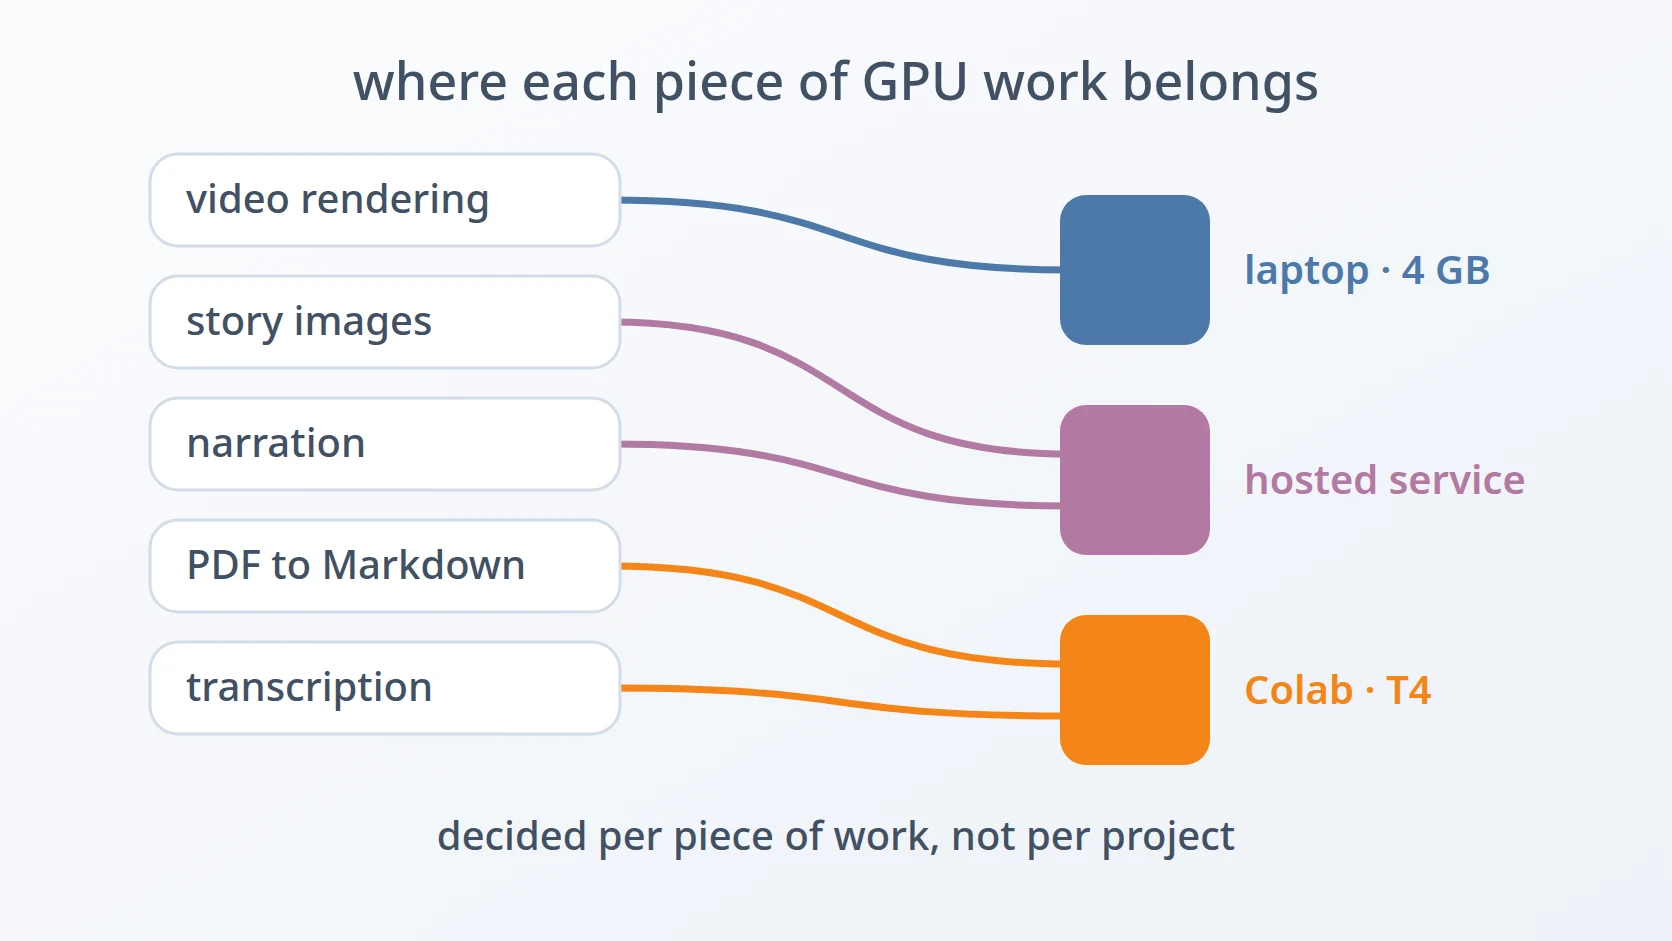
Tak satu pun dari ketiganya cocok untuk semua pekerjaan. Satuan keputusan yang berguna ternyata jauh lebih kecil daripada project. Project slideshow contoh paling jelas: render video, gambar, dan narasinya kini tinggal di tiga tempat berbeda, sementara konverter PDF dan transkriber tetap utuh di Colab. Pembagian itu, beserta alasan di balik tiap bagiannya, menjadi isi artikel ini.
C. Tujuh hambatan yang menghalangi
"Terlalu berat" itu perasaan, dan kriterianya harus angka. Memutuskan berdasarkan kesan akan mengirim semuanya ke mesin yang lebih besar. Batas laptop 4096 MiB, dan model yang butuh sedikit di atas itu tetap tidak muat.
Keputusannya milik tiap potong pekerjaan, bukan tiap project. Memutuskan per project, pilihan yang paling gampang, membuat render video lama bertahan di Colab padahal render tak pernah butuh GPU Colab. Render ada di sana hanya karena bagian project lainnya ada di sana.
Sebagian pekerjaan pergi karena keandalan, bukan karena memori. Model narasi yang saya jalankan sendiri muat di Colab, tapi tetap tak bisa dipercaya. Menyetelnya lebih keras, cara yang pertama saya coba, cuma memindahkan kegagalannya.
Sebagian pekerjaan pergi karena metodenya berganti. Pembuatan gambar tidak pindah ke GPU yang lebih besar. Gambar berhenti dibuat dengan model yang saya jalankan sendiri, dan perubahan itu menghapus satu golongan penuh konsep Colab dari project.
Pekerjaan yang pulang tidak boleh mengandaikan GPU tersedia. Mengunci encoder GPU hanya karena laptop ini punya GPU akan membuat program gagal di mesin mana pun tempat encoder itu tak bekerja — termasuk laptop ini sendiri di hari yang buruk.
Pulang seharusnya menghapus mesin. Membiarkan storage, broker, dan logika resume tetap terpasang "untuk jaga-jaga" adalah pilihan yang paling mudah. Pilihan itu terus membayar ongkos jarak yang sudah tidak ada.
Pekerjaan yang tetap di luar pun masih bisa dilucuti. Transkriber tidak bisa pulang, tapi tidak tiap pemakaiannya butuh seluruh mesin di sekelilingnya. Satu versi lengkap untuk semua jenis pekerjaan adalah pilihan yang ditolak.
Urutannya bergerak dari kriteria ke akibatnya. Mula-mula angkanya, lalu satuan tempat angka itu diterapkan. Sesudah itu dua jenis kepergian yang sama sekali tak berhubungan dengan angka — di situlah kebiasaan paling menyesatkan. Kemudian syarat supaya pekerjaan pulang dengan benar: tanpa mengandaikan GPU, dan tanpa mempertahankan mesin lamanya. Terakhir, kasus ketika pekerjaan tak bisa pulang dan pertanyaan yang berguna bergeser menjadi berapa banyak mesin di sekelilingnya yang masih diperlukan.
Metode
A. Angka sebagai pengganti perasaan
Inilah jawaban atas hambatan pertama. Batasnya bukan perkiraan. Driver melaporkannya langsung:
Semua pekerjaan lain dibandingkan dengan baris itu. Model speech-to-text untuk transkripsi butuh VRAM sekitar 5 GB pada ukuran model yang menghasilkan subtitle layak pakai. Angka itu cuma sedikit di atas 4096 MiB, dan justru "sedikit di atas" inilah jebakan intuisi: kedengarannya cukup dekat untuk dicoba. Kenyataannya tidak. Begitu bobot dan buffer kerjanya tak muat, pemuatan model gagal dengan error out-of-memory, dan pilihan lokalnya tinggal dua: model yang lebih kecil dengan transkrip lebih buruk, atau CPU dengan kecepatan yang tak terpakai. Maka transkripsi tetap di Colab, karena hasil ukur dan bukan karena kebiasaan.
Pengukuran yang sama ikut membentuk perilaku transkriber di Colab. Pemakaian VRAM dibaca lewat nvidia-smi, bukan lewat framework-nya, karena inference engine-nya memegang arena memori sendiri yang tak terlihat oleh framework. Ketika model kehabisan memori, transkriber turun satu tingkat ukuran model dan tidak mengulang model yang sama — alokasi yang baru saja gagal cenderung gagal lagi dengan cara serupa.
Konverter PDF bertahan di Colab dengan alasan yang sama: model layout dan OCR-nya — OCR adalah pengenalan teks pada gambar halaman hasil scan — butuh GPU besar, dan GPU laptop bukan GPU besar. Keduanya bukan penilaian tentang seberapa berat pekerjaan itu terasa. Keduanya perbandingan terhadap angka yang bisa dibaca siapa saja langsung dari mesinnya.
B. Memecah project menjadi potongan
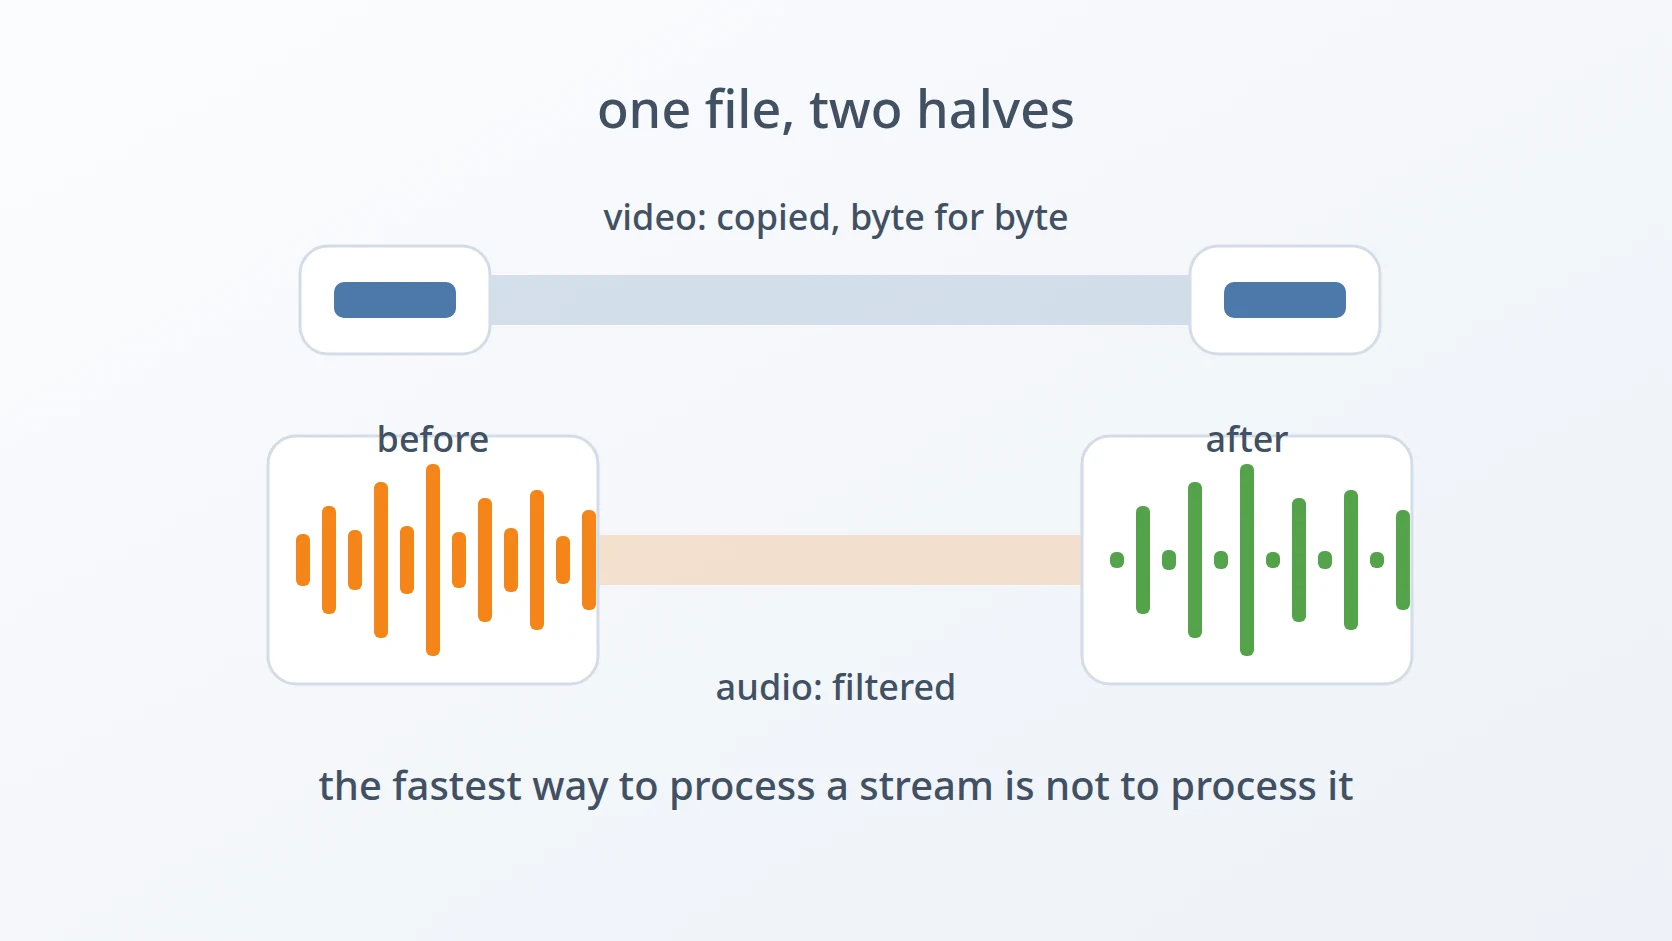
Saya berhenti menempatkan project secara utuh, dan mulai menempatkan potongannya. Project slideshow dulu punya dua worker di Colab, satu untuk gambar dan satu untuk narasi, yang berjalan bersamaan atas project yang sama. Worker gambar juga merender video akhirnya: gambar tiap shot ditampilkan selama durasi audionya, lalu semuanya dirakit jadi satu file dengan FFmpeg, program command-line yang lazim untuk mengonversi dan menggabungkan audio maupun video. Render itu tak pernah butuh GPU Colab. Render berjalan di sana hanya karena gambar dan data project-nya ada di sana, dan karena project itu secara keseluruhan sudah ditaruh di Colab.
Mengajukan pertanyaannya per potong menghasilkan jawaban yang berbeda untuk masing-masing:
| Potong pekerjaan | Tempatnya sekarang | Kenapa di sana |
|---|---|---|
| render video | laptop | FFmpeg muat dengan mudah; di Colab cuma karena datanya di sana |
| gambar cerita | layanan ter-hosting | metodenya berganti, bukan memorinya |
| narasi | layanan ter-hosting | model yang dijalankan sendiri tidak andal |
| PDF ke Markdown | Colab | butuh GPU besar |
| transkripsi | Colab | butuh sekitar 5 GB, di atas 4096 MiB |
Hanya dua baris yang diputuskan oleh angka dari seksi sebelumnya. Tiga baris lainnya diputuskan oleh alasan lain, dan justru di situlah gunanya memecah: keputusan tingkat project akan merata-ratakan alasan-alasan itu menjadi satu jawaban, dan jawaban itu keliru untuk sebagian besar baris. Dua hambatan berikutnya membahas baris-baris yang sama sekali tidak ditentukan oleh memori.
C. Pergi karena keandalan, bukan karena memori
Saya memindahkan narasi keluar dari Colab meski narasinya muat di sana. Narasi dulu dibuat di Colab oleh F5-TTS, model text-to-speech yang saya jalankan sendiri. Model itu muat dengan lega di memori T4. Persoalannya, F5-TTS tidak selalu mengucapkan teks yang diberikan kepadanya. Ujung kata terpotong: kata selangkah keluar tanpa bunyi terakhirnya.
Perbaikan pertama berupa bantalan — beberapa spasi ditambahkan sesudah tiap baris supaya model punya ruang untuk menuntaskan ucapannya. Menaikkan bantalan jadi empat spasi cuma mengubah selangkah menjadi selangka, masih kurang satu huruf, lalu memunculkan potongan baru di tempat lain. Bantalan tidak menghapus kegagalan; bantalan cuma memindahkannya. Gejala itu cocok dengan akarnya: model ini tak punya duration predictor. Panjang ucapan tiap baris diperkirakan dari panjang teksnya, dan cara itu diketahui buruk untuk baris pendek. Tak ada setelan yang bisa memperbaiki model yang tidak tahu berapa lama harus bicara.
Maka saya berhenti mengejarnya. Langkah segeranya jalan pintas manual: salin narasinya, buat suaranya di tempat lain, lalu unggah file audionya kembali ke project untuk shot itu. Pipeline gambar sudah berjalan, dan audio tidak boleh menjadi satu-satunya penghambat video yang selesai. Langkah jangka panjangnya memindahkan narasi ke layanan text-to-speech ter-hosting, dipanggil sekali per shot:
= Tak ada bagian panggilan itu yang bergantung pada VRAM. Keputusan memindahkan narasi memang tak pernah soal memori: pekerjaannya sudah muat di Colab dan tetap pergi, karena model yang muat tapi tak bisa dipercaya bukan tempat pekerjaan itu bisa tinggal.
D. Pergi karena metodenya berganti
Gambar juga saya pindahkan, dan alasannya bukan memori. Gambar dulu dibuat di Colab dengan SDXL, model gambar terbuka yang berjalan baik di T4. Gambar pun pergi, dengan tiga alasan. Konsistensi antargambar yang saya butuhkan — tokoh yang sama, benda yang sama, tampilan yang sama sepanjang satu bab — tidak berhasil saya dapatkan dari SDXL. Model generatif online menghasilkan gambar yang jauh lebih baik. Dan saya ingin tiap shot ditinjau satu per satu oleh operator sebelum diterima, bukan dibuat dalam batch besar lalu dipilah belakangan.
Gambar kini dibuat lewat model generatif online, dikendalikan agent AI melalui skill yang sekaligus menangani tinjauan per shot. Metode yang berganti mengubah apa yang dicatat project. Satu beat — satu momen narasi beserta gambar yang tampil selama momen itu — kini menyimpan brief yang ditulis untuk momen tersebut dan gambar yang diterima untuknya:
Brief itu deskripsi adegan singkat untuk model multimodal, bukan daftar tag SDXL. Field provider mencatat asal gambarnya. Kontrak project menyebut dengan tegas konsep apa saja yang sudah tidak ada: folder storyboard, object key di storage bersama, topic broker, prompt SDXL, dan antrean pembuatan gambar. Tiap konsep itu dulu ada untuk menyuapi model di GPU jarak jauh. Begitu metodenya berganti, tak ada lagi yang perlu disuapi.
E. Pulang tanpa mengandaikan GPU
Saya membuat renderer menguji encoder GPU-nya, bukan mengandaikannya ada. Render video kini berjalan di laptop, dan laptop punya GPU NVIDIA dengan encoder video hardware, NVENC. Wajar saja kalau renderer langsung ditulis untuk NVENC lalu dianggap selesai. Tapi renderer yang mewajibkan NVENC akan gagal di mesin tanpa NVENC — dan, yang kurang kentara, di mesin yang mendaftar NVENC tapi tak bisa memakainya, keadaan yang terjadi sesudah update driver atau dengan build FFmpeg yang tidak cocok.
Karena itu setelan encoder berisi auto secara default, dan auto menguji encoder-nya ketimbang memercayai daftar:
# build yang mendaftar NVENC belum cukup: encode satu frame sungguhan
=
...
# pakai h264_nvenc; selain itu jatuh ke libx264 di CPUProbe meng-encode satu frame berukuran normal, karena NVENC menolak frame sintetis yang sangat kecil dan probe mungil akan melaporkan kegagalan palsu. Hasilnya di-cache, jadi pemeriksaan cuma terjadi sekali. Kalau gagal, render memakai libx264 di CPU. Render-nya lebih lambat, tapi tidak gagal. Pekerjaan yang pulang harus sanggup hidup di mesin yang lebih lemah daripada mesin tempat kodenya ditulis.
F. Pulang seharusnya menghapus mesin
Mesin lama saya hapus, tidak saya simpan. Begitu gambar dan narasi tidak lagi berasal dari Colab, dan render berjalan di laptop, project slideshow tak punya apa-apa lagi di mesin pinjaman. Storage bersama, broker, logika resume, dan kontrak antara antarmuka dan worker semuanya ada untuk menjembatani jarak yang kini sudah hilang. Perubahan yang memulangkan project itu terutama terukur dari yang dibuangnya:
|
Hampir tujuh baris terhapus untuk tiap baris yang ditambahkan. Data project yang dulu tersebar di object key dalam bucket kini cukup satu folder di disk lokal:
Mempertahankan mesin lama "kalau-kalau pekerjaannya kembali" memang menggoda, sebab membangunnya butuh usaha sungguhan dan mesin itu bekerja. Tapi mesin yang dipertahankan tanpa alasan tetap harus dipahami, diperbarui, dan diamankan, dan diam-diam ia membentuk cara fitur baru ditulis: tiap fitur baru akan dibangun di sekitar broker yang tidak dibutuhkannya. Infrastruktur yang dibangun untuk mengatasi keterbatasan sebaiknya cukup longgar untuk dilepas ketika keterbatasannya hilang.
G. Yang tetap di luar pun bisa dilucuti
Untuk transkripsi, yang saya ubah adalah sekeliling pekerjaannya, bukan tempatnya berjalan. Transkripsi tidak bisa pulang, seperti yang ditunjukkan seksi pertama. Transkriber versi lengkap punya antarmuka di laptop, storage bersama untuk media dan transkrip, serta broker untuk perintah — bentuk yang tepat untuk aliran pekerjaan yang terus-menerus. Untuk satu-dua rekaman cepat, atau ketika antarmuka maupun storage-nya tak bisa dipakai, semua itu mesin yang terlalu banyak untuk pekerjaan sekecil itu.
Karena itu ada varian headless: tetap berjalan di Colab, tapi tanpa antarmuka, tanpa storage bersama, dan tanpa broker. Rekaman diseret ke satu folder di runtime, nomornya dipilih dari dalam notebook, dan tiap transkrip ditulis di sebelah rekamannya. Status tidak disimpan di mana pun; status diturunkan dari ada atau tidaknya file subtitle:
=
continue
# .srt yang sudah ada berarti selesai
continue
return Dengan begitu file subtitle berperan sebagai penanda selesai, jadi file itu ditulis sekali, utuh, dan hanya ketika transkripnya tuntas. File yang baru separuh tertulis akan membuat pemindaian berikutnya melewati rekaman itu selamanya. Rekaman yang gagal tidak meninggalkan file apa pun, dan cukup ditawarkan lagi pada pemindaian berikutnya. Inti transkripsinya dibawa dari versi lengkap, bukan ditulis ulang, sehingga kedua varian mentranskripsi dengan cara yang sama; yang berbeda cuma sekelilingnya.
Keputusan ini berbeda jenisnya dari yang lain. Pekerjaannya tidak dipindah ke mana-mana. Yang berubah adalah berapa banyak yang dibungkus di sekeliling pekerjaan itu, di tempat yang sama tempat ia sudah berjalan.
Hasil dan Pembahasan
A. Hasil dari tujuh keputusan
Project slideshow kini berjalan sepenuhnya dari laptop: data project di satu folder lokal, render dengan FFmpeg memakai encoder mana pun yang benar-benar bekerja, serta gambar dan narasi yang diminta dari layanan ter-hosting. Konverter PDF dan transkriber tetap di Colab, dan transkriber punya varian headless untuk pekerjaan kecil. Tak ada potong pekerjaan yang berada di tempatnya karena kebiasaan.
| Keputusan | Yang didapat | Alternatif yang ditolak |
|---|---|---|
| bandingkan dengan 4096 MiB | penempatan yang bisa diperiksa siapa saja | memutuskan dari seberapa berat pekerjaan terasa |
| putuskan per potong pekerjaan | tiap potong ditempatkan karena alasannya sendiri | satu penempatan per project |
| narasi ter-hosting | baris diucapkan utuh | menyetel bantalan pada model tanpa duration predictor |
| model gambar online dengan tinjauan per shot | gambar konsisten, masing-masing diterima | batch generation dengan SDXL di Colab |
| encoder auto dengan probe sungguhan | render jalan di mesin mana pun, lebih lambat tanpa NVENC | mengunci encoder GPU |
| hapus mesin penjembatan jarak | 9975 baris lebih sedikit untuk dirawat | menyimpan storage dan broker untuk jaga-jaga |
| varian headless untuk pekerjaan cepat | tanpa antarmuka, storage, atau broker bila tak dibutuhkan | satu versi lengkap untuk semua pekerjaan |
B. Dua pertanyaan, bukan satu
Di awal, keputusannya tampak seperti satu pertanyaan: pekerjaan ini dijalankan di mana? Menyelesaikan tujuh hambatan menunjukkan bahwa pertanyaannya ada dua. Yang pertama, di mana pekerjaan berjalan — laptop, runtime pinjaman, atau layanan ter-hosting. Yang kedua, seberapa banyak mesin yang mengelilinginya di tempat itu — antarmuka, storage bersama, broker, logika resume, atau tidak satu pun.
Keduanya bisa disetel sendiri-sendiri, dan jawaban terbaik justru muncul saat keduanya disetel terpisah. Render pulang dan kehilangan seluruh mesinnya sekaligus. Transkriber tetap persis di tempatnya dan masih bisa melepas sebagian besar mesinnya untuk pekerjaan kecil. Narasi dan gambar meninggalkan GPU saya sepenuhnya, dan kepergian itu menghapus mesin yang dulu menyuapi keduanya tanpa ada satu bagian pun yang perlu dipindah.
Di balik kedua pertanyaan itu ada satu pengamatan yang sama: alasan pekerjaan berada di suatu tempat sering kali bukan alasan pekerjaan itu dulu ditaruh di sana. Render ada di Colab karena project-nya di Colab. Narasi ada di Colab karena muat, bukan karena berhasil. Memisahkan alasan-alasan itu, satu potong demi satu potong, adalah bagian terbesar pekerjaannya.
C. Yang tidak dicakup
Penempatan ini tidak permanen. Kriterianya bergerak: model makin ringan, GPU diganti, kebutuhan berubah. Jawaban di tabel atas menggambarkan keadaan kriteria saat ini. Yang semestinya bertahan lebih lama adalah cara di baliknya — ukur kebutuhan pekerjaannya, bandingkan dengan yang dimiliki mesinnya, lalu periksa apakah memori memang alasan penentunya.
Layanan ter-hosting membawa ketergantungan yang tidak diselesaikan artikel ini. Ketika narasi atau gambar datang dari model orang lain, mutunya, setelan yang tersedia, dan perilakunya terhadap input tak lazim sepenuhnya boleh mereka ubah. Tinjauan per shot menempatkan manusia, atau agent yang bertindak atas namanya, di antara model dan video jadinya, tapi tidak menjadikan keputusan penyedia itu keputusan saya.
Konverter PDF dan transkriber masih bergantung pada Colab, dengan semua batas yang menyertainya: panjang sesi, kuota GPU harian, dan aturan tentang cara runtime boleh dipakai. Mesin yang membuat keduanya bisa dipakai masih dibutuhkan, dan masih harus dirawat.
Simpulan
GPU 4 GB membuat tiap pekerjaan berat dikirim ke Colab, dan untuk beberapa waktu satu aturan itu membentuk semua project. Mengajukan pertanyaannya lagi, satu potong demi satu potong, menghasilkan lima jawaban berbeda. Render pulang karena tak pernah butuh GPU besar. Narasi pergi karena keandalan, sesudah bantalan cuma memindahkan kegagalannya. Gambar pergi karena metodenya berganti, dan membawa serta satu golongan penuh konsep Colab. Konverter PDF dan transkriber tetap tinggal, karena angka mengharuskannya.
Kepulangan itu dikerjakan tanpa mengandaikan GPU, dengan encoder yang dipilih lewat pengujian dan bukan lewat daftar, dan terukur terutama dari jumlah baris yang dihapus. Untuk pekerjaan yang harus tetap di luar, mesin yang tak dibutuhkannya masih bisa dilucuti.
Pelajaran yang terbawa: perlakukan penempatan sebagai keputusan per potong pekerjaan, berpijak pada ukuran yang bisa diperiksa — dan bangun mesin penjembatan jarak sedemikian rupa sehingga bisa dibongkar begitu jaraknya hilang.
Istilah
- VRAM
- Memori pada GPU. Model beserta buffer kerjanya harus muat di sini supaya bisa berjalan di GPU itu.
- runtime
- Virtual machine yang dipinjamkan Colab untuk satu sesi, termasuk GPU-nya. Runtime berakhir ketika sesinya berakhir.
- layanan ter-hosting
- Model yang dijalankan pihak lain dan dijangkau lewat API. Pekerjaan dikirim sebagai request, lalu hasilnya kembali.
- duration predictor
- Bagian model text-to-speech yang menentukan berapa lama tiap potong ucapan berlangsung. Tanpanya, durasi harus diperkirakan dari teks.
- NVENC
- Encoder video hardware pada GPU NVIDIA. FFmpeg bisa memakainya lewat encoder seperti
h264_nvenc. - libx264
- Encoder H.264 software yang berjalan di CPU. Lebih lambat daripada NVENC, tapi tersedia di mana pun FFmpeg ada.
- beat
- Satu momen narasi dalam slideshow, beserta gambar yang tampil selama momen itu diucapkan.
- headless
- Berjalan tanpa antarmuka apa pun. Pekerjaan dipilih dari dalam notebook, dan hasilnya dibaca langsung dari tempat ia ditulis.
- penanda selesai
- File yang keberadaannya berarti satu pekerjaan sudah tuntas. File ini hanya boleh ditulis setelah pekerjaannya benar-benar selesai.
Technologies covered
- Python
- FFmpeg
- Google Colab
- GPU
- SDXL