Release Workflow: Development to Production
On this page
Release Workflow: Development to Production adalah prosedur yang ditempuh tiap perubahan saya, dari laptop tempat ia ditulis sampai environment production tempat orang memakainya. Prosedur ini berjalan tiap kali versi baru salah satu service siap, dan baru selesai ketika sistem production sudah sekali menjalankan fungsi intinya dengan data sungguhan.
Halaman ini bukan tutorial deployment. Isinya cara saya berpikir tentang pekerjaan yang sering saya ulang: langkah mana yang saya otomatiskan, mana yang sengaja saya serahkan ke manusia, dan kenapa tiap langkah berada di tempatnya.
Sekilas
| Pemicu | Versi baru salah satu service siap dirilis |
|---|---|
| Frekuensi | Sekali per rilis, untuk satu atau beberapa service |
| Masukan | Kode yang berubah, backup production terbaru, akses ke environment staging |
| Hasil | Production menjalankan versi baru, dengan konfigurasi dan database yang sudah dimigrasikan |
| Selesai bila | Production sudah sekali menjalankan fungsi intinya dari awal sampai akhir dengan data sungguhan |
Pekerjaan berulangnya
Rilis bukan satu tindakan, melainkan rangkaian tindakan, dan tiap mata rantainya bisa gagal dengan cara yang baru tampak belakangan: image yang sudah diuji tapi tak pernah diterbitkan, file konfigurasi yang tersalin menimpa secret production, migrasi database yang diam-diam tak berjalan, sistem yang melaporkan dirinya sehat padahal fitur utamanya rusak. Mengerjakannya dengan tangan sekali masih bisa. Mengerjakannya untuk tiap rilis tiap service, dengan jarak berbulan-bulan, adalah cara langkah-langkahnya terlewat.
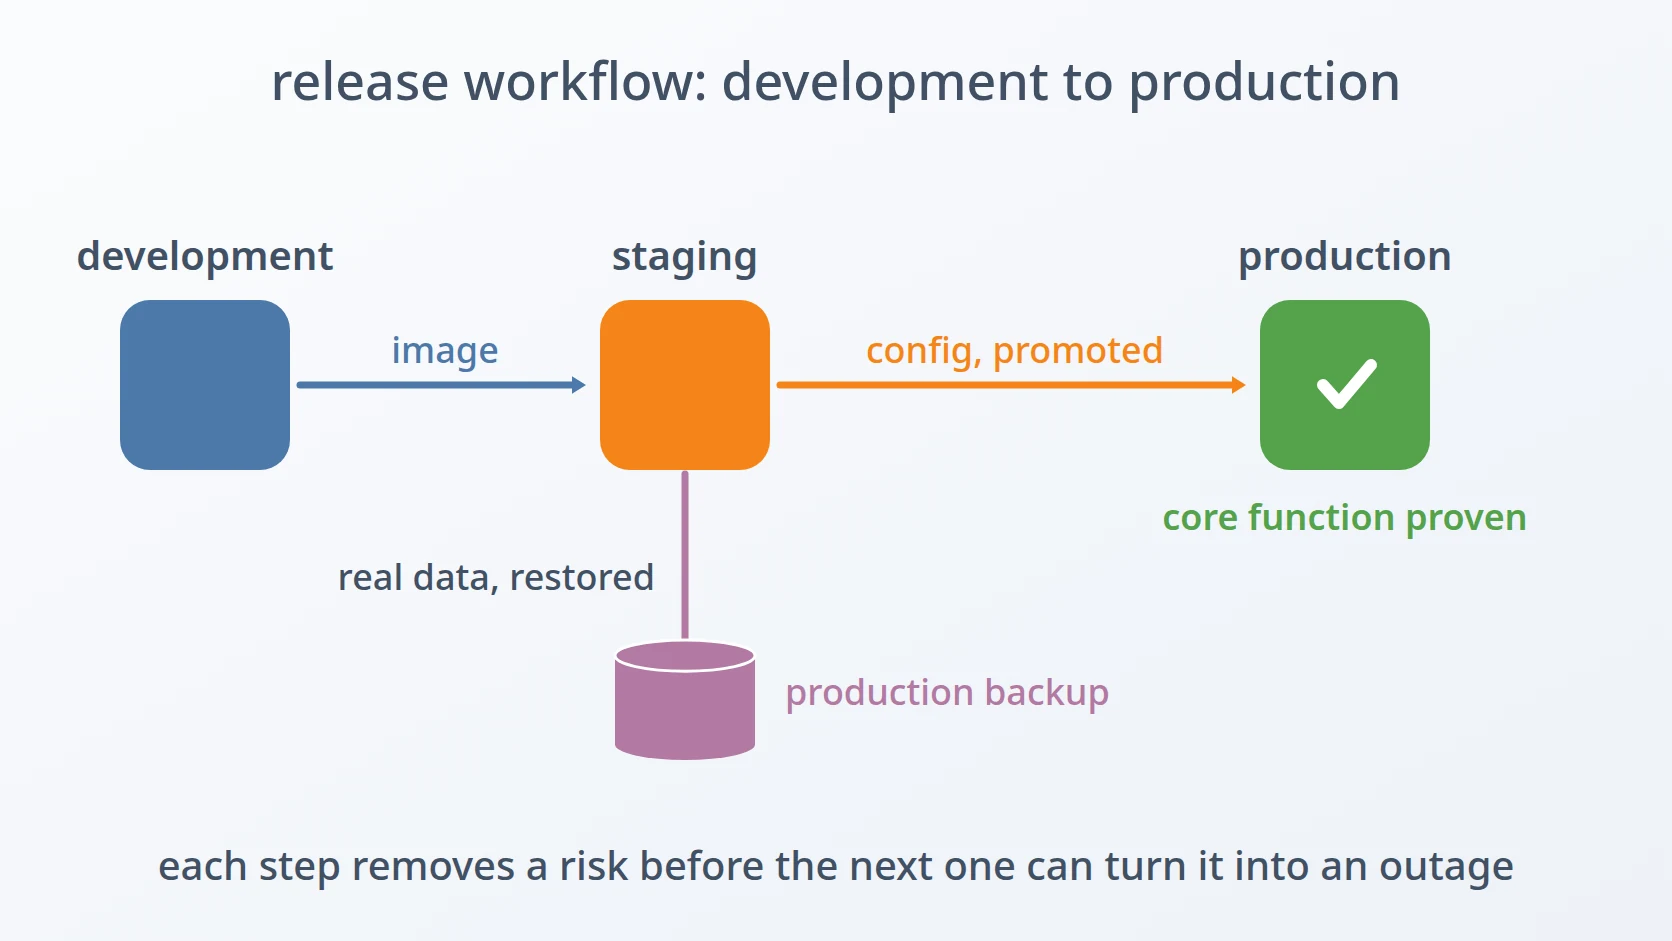
Karena itu saya menjadikan rilis sebagai prosedur dengan urutan tetap. Tiap langkah menyingkirkan satu risiko sebelum langkah berikutnya sempat mengubahnya menjadi gangguan, dan langkah yang gampang keliru dijadikan script, bukan ingatan.
Alurnya
- Kembangkan di laptop dengan domain asli, periksa layanan luar, jalankan test.
- Bangun image, lalu terbitkan sebagai langkah terpisah.
- Lahirkan environment staging dari backup production terbaru, lalu uji rilisnya di sana.
- Promosikan konfigurasi ke production — dry run lebih dulu.
- Nyalakan production, migrasikan, dan periksa kesehatannya.
- Buktikan fungsi inti sekali dengan data sungguhan, lalu bebaskan atau hapus staging.
Langkah dan keputusan di baliknya
Kembangkan dengan domain asli. Laptop saya melayani domain yang sama dengan sertifikat yang sama seperti production, jadi cookie, redirect, dan callback berperilaku di development persis seperti nanti di production. Saya memutuskan meniru production apa adanya di lokal, bukan sekadar mendekatinya, karena bug yang lahir dari nama yang berbeda baru muncul sesudah rilis, di tempat yang paling buruk untuk men-debug-nya.
Periksa layanan luar sebelum kode bergantung padanya. Ketika rilis mulai memakai storage server, identity provider, atau akun email, saya menjalankan pemeriksaan kesiapan atas credential-nya lebih dulu. Kegagalan yang tertangkap di sini jelas milik layanannya; kegagalan yang sama bila tertangkap sesudah rilis tampak seperti bug di kode saya.
Jalankan test otomatis. Test wajib lolos sebelum image dibangun. Image yang tak lolos test-nya sendiri bukan calon rilis, jadi tak ada alasan menghabiskan sisa prosedur untuknya.
Bangun image, lalu terbitkan secara terpisah. Tiap service punya nomor versinya sendiri, jadi rilis biasanya hanya membangun ulang service yang berubah. Script build menaikkan versi dan membangun image-nya, tapi sengaja tidak mem-push-nya. Penerbitan adalah langkah tersendiri yang terlihat, karena uji atas image yang tak pernah diterbitkan tak membuktikan apa pun tentang yang akan dijalankan server.
Lahirkan staging dari backup production terbaru. Satu perintah merakit stack untuk versi ini, memulihkan data dari backup, menyalakan service-service-nya, menjalankan migrasi database, lalu memeriksa kesehatannya. Datanya berasal dari backup, tak pernah langsung dari production, jadi staging bisa dilahirkan ulang sesering apa pun tanpa menyentuh production. Memakai backup dengan cara ini juga membuktikan, tiap kali rilis, bahwa backup-nya memang bisa dipulihkan.
Uji rilisnya di staging. Staging memegang data sungguhan dan menjalankan image yang sudah diterbitkan, tak pernah image lokal, jadi uji di sana menjalankan persis yang akan dijalankan production terhadap jenis data yang sama. Langkah ini tetap manual: memutuskan bahwa rilis berperilaku benar adalah penilaian, bukan pemeriksaan yang bisa dikerjakan script.
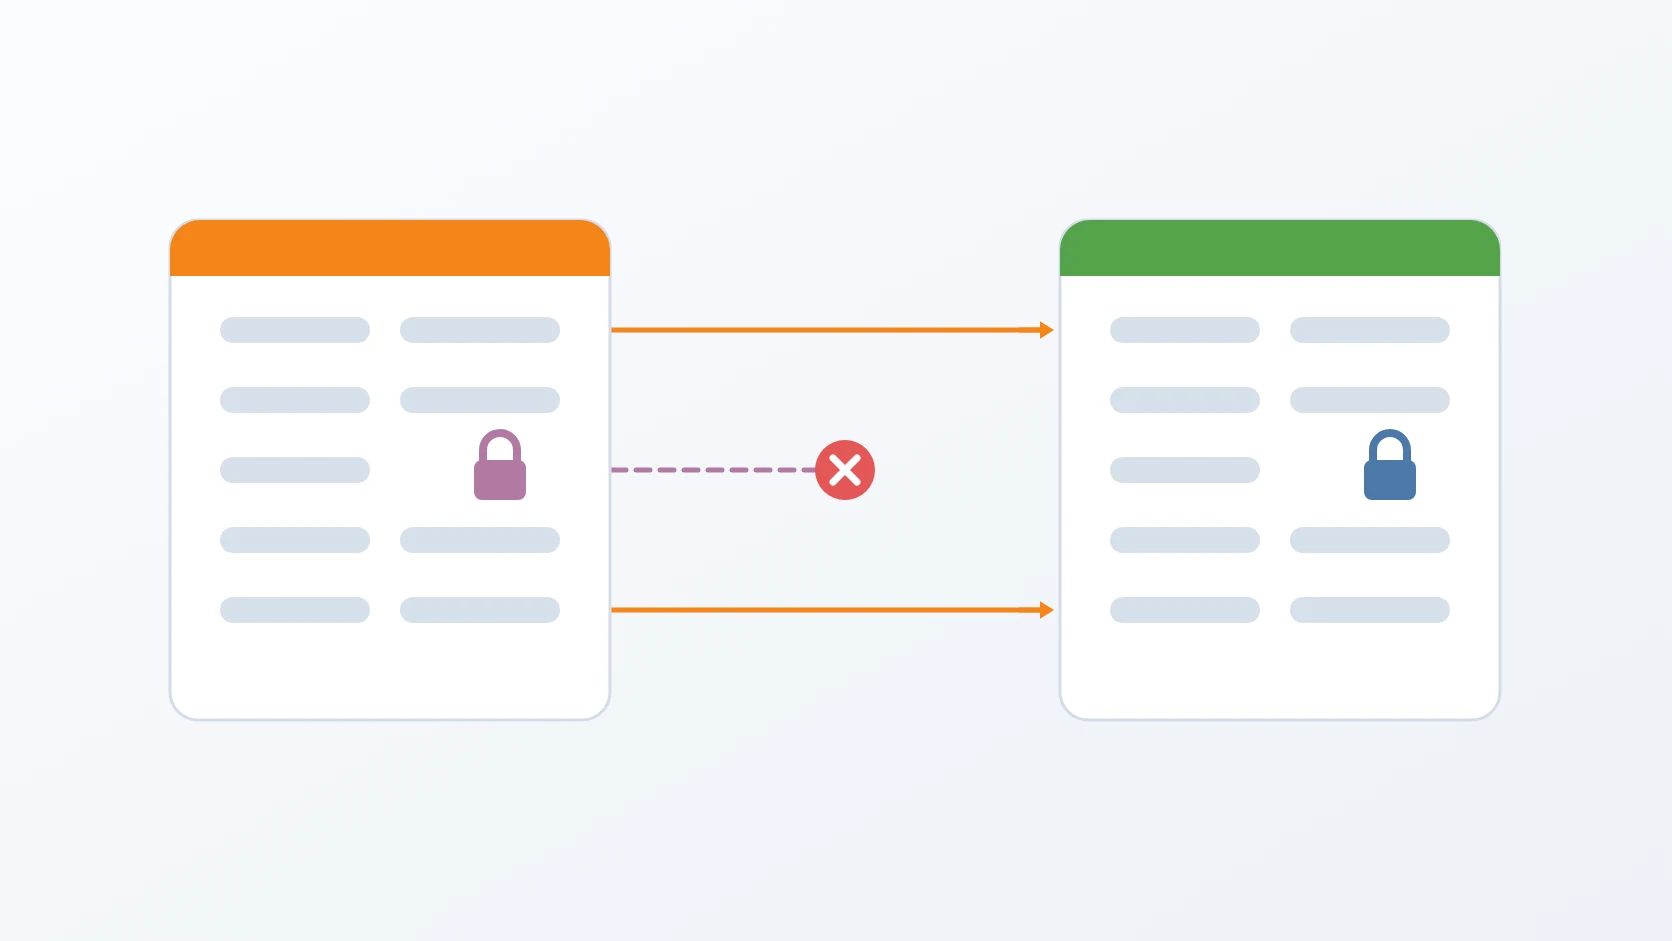
Promosikan konfigurasi — dry run lebih dulu. Konfigurasi tidak disalin dari staging ke production. Script promosi memindahkan strukturnya: key yang ditambah atau dibuang, serta nilai yang bukan rahasia. Secret dan alamat tetap milik production sendiri, secret yang hanya ada di staging menghentikan script sampai saya mengisi nilai production-nya dengan tangan, dan tiap file yang ditulisnya di-backup lebih dulu. Dry run memperlihatkan tiap perubahan sebelum apa pun ditulis.
Nyalakan production, migrasikan, dan periksa kesehatannya. Migrasi yang sama seperti di staging dijalankan secara eksplisit, diikuti pemeriksaan kesehatan yang sama. Migrasi yang tak dijalankan service saat ia menyala mendapat langkahnya sendiri, supaya perubahan skema tak pernah bisa bersembunyi di balik container yang menyala dengan mulus.
Buktikan fungsi inti sekali. Container yang sehat tidak membuktikan bahwa sistemnya mengerjakan tugasnya. Rilis belum selesai sampai production menjalankan fungsi intinya sekali, dari awal sampai akhir, dengan data sungguhan — di platform tanda tangan dokumen, misalnya, berarti menandatangani satu dokumen sungguhan.
Bebaskan atau hapus staging. Begitu pengujian selesai, staging dihentikan supaya memori server lega. Ketika versi itu tak lagi dibutuhkan, ia dihapus seluruhnya: container, folder, state, dan konfigurasi web server, supaya environment lama tak menumpuk tanpa disadari.
Yang saya otomatiskan, dan yang sengaja tidak
| Langkah | Otomatis atau manual | Alasan |
|---|---|---|
| Pemeriksaan kesiapan, test | otomatis | pertanyaannya sama tiap kali; mesin mengajukannya lebih cepat dan tak pernah melewatkan satu pun |
| Build | otomatis | menaikkan versi dan membangun image harus identik di tiap rilis |
| Penerbitan | manual, disengaja | push image adalah titik tak bisa kembali untuk yang dijalankan server; ia harus jadi tindakan sadar |
| Melahirkan staging | otomatis, satu perintah | restore, nyalakan, migrasi, dan periksa terlalu banyak untuk diulang dengan tangan tanpa ada yang terlewat |
| Uji di staging | manual | benar tidaknya perilaku rilis adalah penilaian |
| Promosi konfigurasi | otomatis, dengan dry run | menyalin file dengan tangan adalah cara secret tertimpa; dry run membuat saya tetap ikut memutuskan |
| Secret baru | manual | nilai secret harus dipilih untuk production, tak pernah diwarisi dari staging |
| Migrasi dan pemeriksaan kesehatan | otomatis | migrasi yang terlupa gagal tanpa suara |
| Membuktikan fungsi inti | manual | hanya transaksi sungguhan yang membuktikan rilisnya; inilah definisi selesai |
| Menghapus staging | otomatis, satu perintah | bersih-bersih gampang terlupa dan melelahkan bila dikerjakan tuntas |
Saat gagal
Sebelum memilih jalan kembali, saya mencari tahu persis di mana rilisnya patah, dan tempat saya mencari bergantung pada cara ia gagal.
Bila production tak menyala atau tak sehat, penyebabnya hampir selalu tercetak di tempat kegagalan itu terjadi: di keluaran terminal saat promosi dan saat menyalakan service-service-nya. Variable yang hilang, migrasi yang berhenti, container yang keluar — semua itu tampak di sana, bukan di log sistem yang memang tak pernah menyala.
Bila semuanya menyala dan sehat tapi ada fitur yang gagal, misalnya tanda tangan yang tak tuntas, saya menelusuri request-nya lewat log dan trace yang dikirim service-service ke OpenTelemetry Collector lalu ke Elasticsearch, untuk menemukan titik persis tempat ia keliru.
Baru sesudah itu saya memilih cara pulih, sesuai yang ditunjukkan diagnosisnya:
- Jalankan image versi sebelumnya bila kode barunya yang salah dan datanya utuh.
- Pulihkan dari backup bila migrasi sudah terlanjur mengubah atau merusak data.
- Perbaiki maju (fix forward) bila masalahnya kecil dan jelas: betulkan, bawa lewat staging, lalu rilis versi baru.
Kenapa urutan ini
Urutan ini memindahkan tiap risiko ke tempat yang paling murah untuk menghadapinya. Masalah layanan luar tertangkap di laptop saya, sebelum ada kode yang bergantung padanya. Data uji berasal dari backup, jadi staging bisa dilahirkan ulang dengan bebas dan backup-nya ikut terbukti. Konfigurasi dipromosikan menurut strukturnya, jadi rilis tak pernah bisa menimpa secret production. Migrasi dijalankan secara eksplisit di kedua sisi, jadi perubahan skema tak bisa bersembunyi di balik pemeriksaan kesehatan yang hijau. Dan langkah terakhirnya transaksi sungguhan, karena itulah satu-satunya alasan sistem itu ada.
Variasi
Hanya satu service yang berubah. Inilah kasus yang biasa. Hanya service itu yang dibangun dan diterbitkan dengan versi baru; service lain tetap di versi yang sudah dijalankannya, dan staging dilahirkan dengan kombinasi itu.
Perbaikan darurat. Hotfix menempuh jalur yang sama, bukan jalan pintas di sekitarnya. Yang dipersingkat adalah uji di staging, yang hanya mencakup bagian yang diperbaiki, bukan seluruh rilis. Melewati staging sepenuhnya menghemat beberapa menit dan mempertaruhkan persis jenis kegagalan yang hendak dicegah prosedur ini.
Istilah
- Staging
- Environment yang meniru production, lengkap dengan salinan datanya, dipakai untuk menguji rilis sebelum ia tayang.
- Image
- Salinan service yang dikemas dan diberi versi, lengkap dengan semua yang dibutuhkannya untuk berjalan, tempat container dinyalakan.
- Migrasi
- Perubahan skema database yang diberi versi, dijalankan berurutan dan dicatat supaya hanya berjalan sekali.
- Dry run
- Menjalankan script sehingga ia melaporkan apa yang akan diubahnya tanpa mengubah apa pun.
- Pemeriksaan kesehatan
- Uji otomatis bahwa service sudah menyala dan bisa menjawab, yang tak mengatakan apa pun tentang berfungsi tidaknya fitur-fiturnya.
- Fix forward
- Pulih dari rilis yang gagal dengan merilis versi yang sudah dibetulkan, bukan kembali ke versi sebelumnya.
Technologies covered
- Docker