Bagaimana Saya Memenuhi RTO dan RPO Business Continuity Plan dengan Beberapa Script Kecil
On this page
- Pendahuluan
- A. Arti kata-katanya, sebelum saya memakainya
- B. Empat hambatan yang menghalangi
- Metode
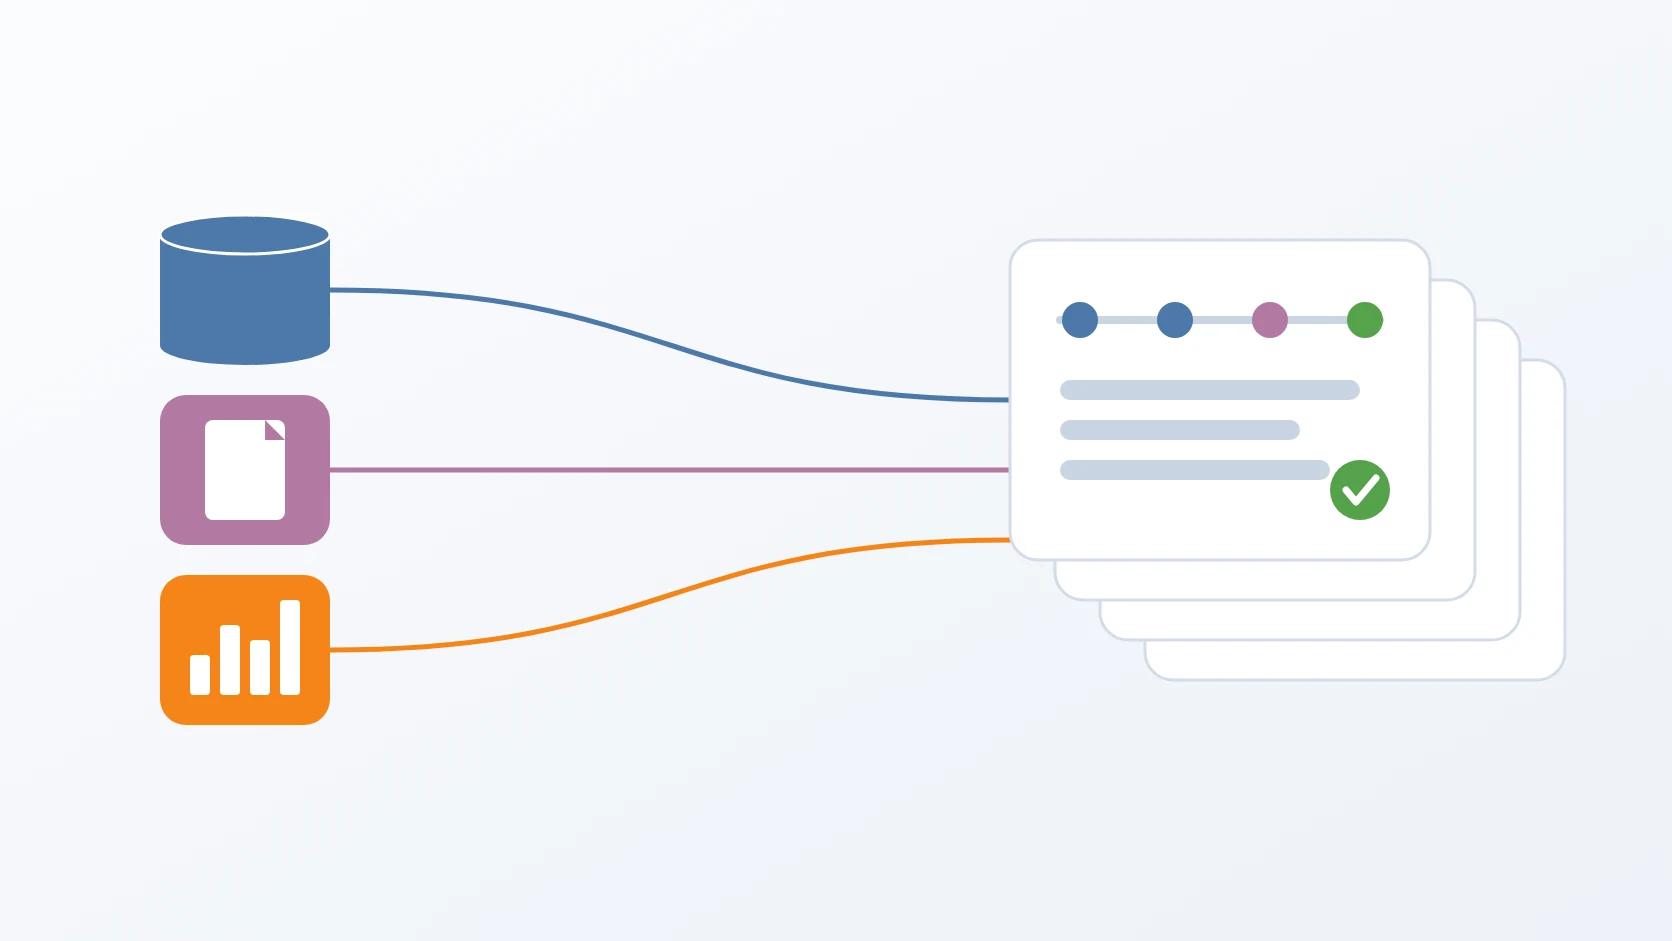
- A. Teknik berbeda untuk setiap data store
- B. Restore point ber-hardlink untuk object storage
- C. Snapshot, bukan salinan file, untuk search cluster
- D. Config dan credential adalah bagian dari data
- E. Tata letak, atomicity, dan path yang tak bergantung pada tempat berdiri
- F. Retention dan schedule yang bisa diungkapkan cron
- Hasil dan Pembahasan
- A. Dua kegagalan yang bakal tampak seperti keberhasilan
- B. Exit code sebagai pernyataan tentang nilai
- C. Apa yang dikatakan angkanya, dan apa yang tidak
- D. RTO dan RPO, dinyatakan
- Simpulan
- Istilah
Sistemnya menandatangani dokumen untuk instansi pemerintah daerah. Seseorang mengirim dokumen, menerimanya kembali dalam keadaan tertandatangani, dan tanda tangan itu harus masih sah bertahun-tahun sesudahnya. Artinya catatan di belakangnya wajib selamat dari apa pun yang menimpa mesin tempatnya tersimpan. Kewajiban itu punya nama di dalam kontrak — Business Continuity Plan — dan rencana baru berarti bila ia bisa dibuktikan, bukan sekadar dinyatakan.
Sekarang yang saya punya adalah beberapa ratus baris shell di cron — penjadwal Linux yang menyalakan perintah pada waktu yang ditentukan — yang mem-backup tiga data store dengan tiga cara berbeda, dan me-restore ketiganya dalam sekitar tujuh detik. Yang ingin saya ceritakan bukan script-nya, melainkan bagaimana bentuk itu akhirnya ketemu. Script-nya terikat pada stack yang belum tentu dipakai siapa pun selain saya; penalarannya tidak. Dan sebagian besar penalaran itu lahir dari dua kegagalan yang selama berhari-hari menyamar sebagai keberhasilan.
Pendahuluan
Business Continuity Plan bukan map berisi backup. Ia jawaban tertulis atas dua angka yang sudah diputuskan orang di luar teknik, entah mereka memakai istilah ini atau tidak: Recovery Time Objective (RTO), berapa lama layanan boleh mati sebelum matinya berubah jadi persoalan kontrak, dan Recovery Point Objective (RPO), berapa banyak pekerjaan terakhir yang boleh hilang saat layanan itu hidup lagi. RTO menentukan seberapa cepat restore harus selesai. RPO menentukan seberapa sering backup harus jalan. Hampir semua keputusan teknis di artikel ini turunan dari salah satu angka itu, dan rencana yang tak menyebut keduanya sebenarnya belum jadi rencana — baru kebiasaan menyalin file, yang berbeda meski pakaiannya mirip.
Cara pandang itu mengubah arti "sudah punya backup". Backup yang belum pernah dipakai untuk restore itu klaim, belum kemampuan. Nilainya baru ditentukan pada hari ia dipakai, dan sampai hari itu tiba semua backup sama-sama meyakinkan. Maka pertanyaan yang berguna tak pernah soal ada atau tidaknya backup, melainkan apakah saya sanggup menyebutkan — dengan angka, bukan dengan rasa percaya diri — berapa lama sistem akan mati dan berapa banyak yang akan lenyap.
Ada satu hal soal kasus itu yang perlu dipisahkan dari sisanya, sebab ia menjelaskan satu pilihan yang kalau tidak begitu akan terlihat berlebihan. Penandatanganan dokumen itulah alasan sistem yang satu ini menyimpan log, trace, dan metric-nya dalam waktu panjang: ketika sebuah tanda tangan dipersoalkan bertahun-tahun kemudian, telemetri di sekitarnya ikut menjadi bagian dari catatan. Karena itulah search cluster yang memegang telemetri di sini ikut di-backup dan bisa dipulihkan. Kebanyakan aplikasi tak punya kewajiban semacam itu dan boleh saja membiarkan telemetrinya kedaluwarsa — dua data store berikutnya, database dan object storage, sama sekali tak berkaitan dengan penandatanganan dan tetap perlu di-backup di sistem mana pun. Yang jadi pokok bahasan adalah rencananya; penandatanganan cuma yang menentukan masa retensinya.
A. Arti kata-katanya, sebelum saya memakainya
Beberapa istilah menopang seluruh tulisan ini, jadi maknanya perlu dipatok lebih dulu. Backup full menangkap keadaan lengkap satu data store pada satu momen: ia berdiri sendiri dan bisa di-restore tanpa bersandar pada apa pun. Backup incremental hanya menangkap yang berubah sejak backup sebelumnya, sehingga kecil dan cepat, tapi tak berguna kalau sendirian — ia baru bisa di-restore setelah digabungkan dengan full leluhurnya beserta semua incremental di antaranya. Keduanya dipakai berbarengan karena alasan yang sederhana: cuma full yang bisa di-restore sendirian, sementara mengambil full tiap beberapa jam terlalu mahal. Jadi full menancapkan jangkar rantai, incremental memanjangkannya dengan ongkos kecil, sampai full berikutnya memulai rantai yang baru.
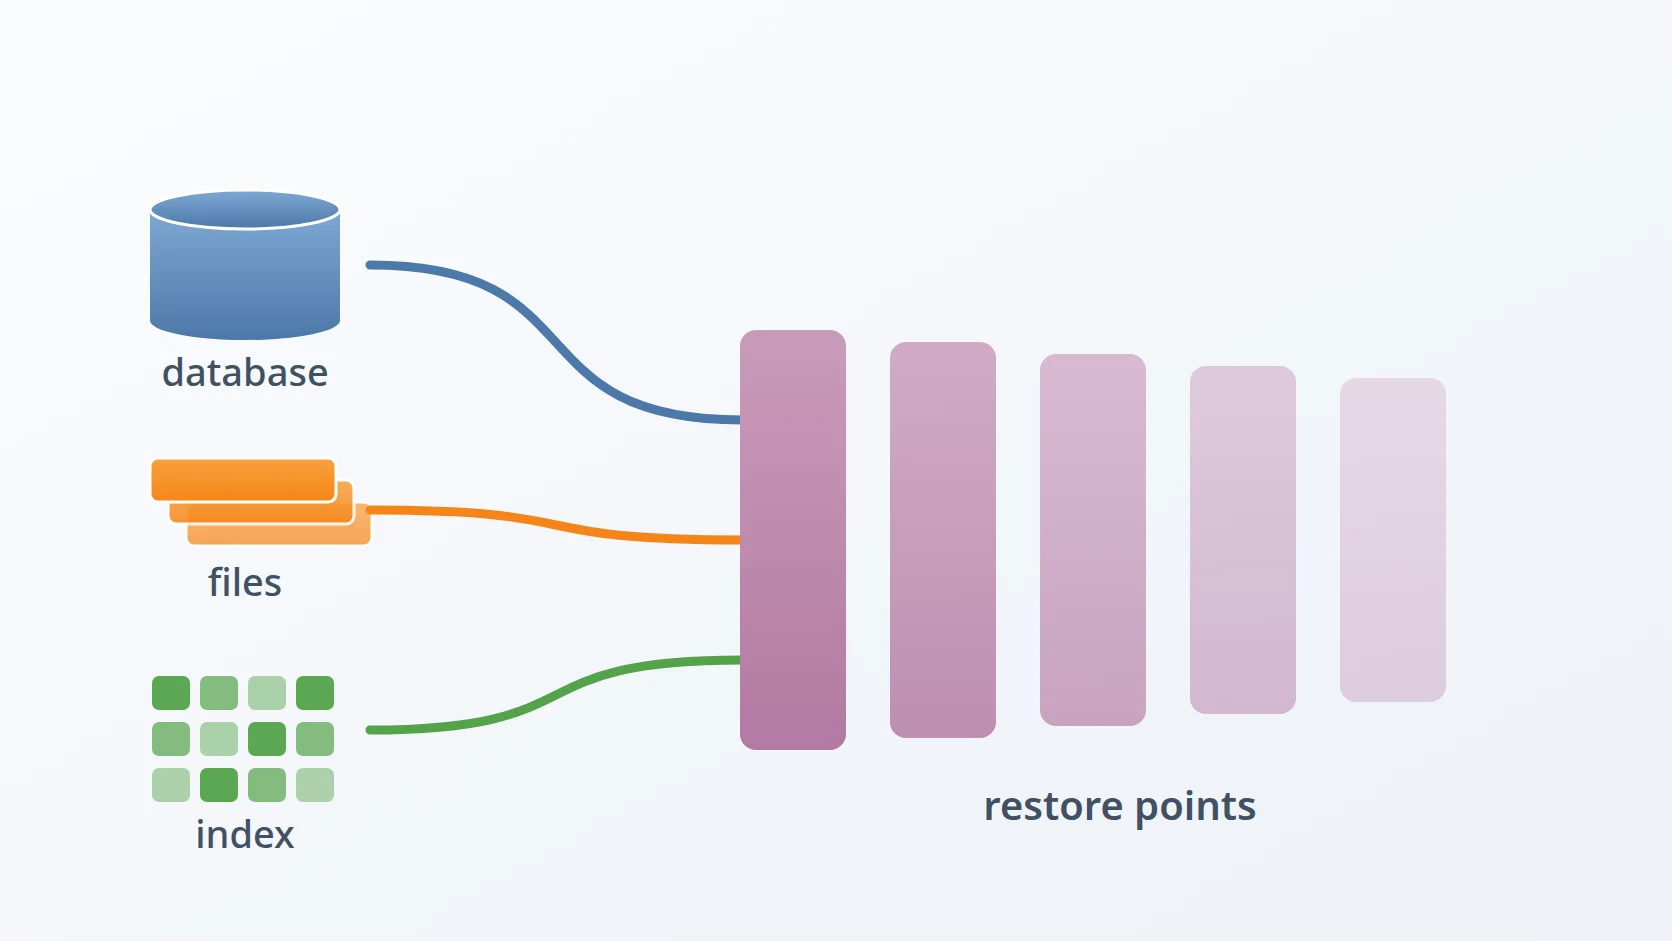
Yang keluar dari mekanisme itu disebut restore point: satu direktori yang mewakili keadaan lengkap sistem pada satu momen, dan itulah yang sebenarnya kita pilih ketika memutuskan untuk mundur ke belakang. Restore point berbeda dari tumpukan file hasil salin, sebab ia juga merekam apa yang dihapus. File yang masih ada Selasa lalu dan dibuang hari Rabu wajib tetap muncul di point Selasa dan wajib absen di point Rabu. Tanpa itu, "restore ke Selasa" diam-diam berarti "restore semua yang pernah ada sampai Selasa", dan sistem yang lahir dari situ bukan sistem yang dulu berjalan.
Retention adalah aturan yang memutuskan point mana bertahan dan point mana dihapus demi membebaskan disk. Setiap sistem backup membutuhkannya, karena disk terbatas sementara tak ada bagian lain dari desain yang pernah membuang apa pun. Di sinilah dua angka dari rencana tadi masuk lagi: menyimpan lebih banyak point berarti membayar storage lebih besar, dan yang dibeli adalah kesanggupan mundur lebih jauh — berguna ketika kegagalannya bukan mesin tumbang, melainkan kerusakan data yang baru ketahuan seminggu kemudian.
Satu hal lagi perlu disebut sejak awal, karena inilah cara paling lazim sebuah backup pertama ternyata tak berharga. Menggoda sekali memperlakukan database seperti map biasa: berhenti berpikir, cp -r direktori datanya, selesai. Padahal database yang sedang hidup tidak menjaga file-nya tetap siap di-restore dari detik ke detik. Ia menahan perubahan terakhir di memori, menuliskannya ke disk dalam urutan yang dipilih demi kecepatan dan bukan demi kenyamanan pembaca, lalu menulis ulang file internalnya justru sementara kita sedang menyalin. Salinan semacam itu merekam awalnya pada satu titik waktu dan akhirnya pada titik lain beberapa detik kemudian, tanpa jaminan keduanya menggambarkan database yang sama dan konsisten. Hasilnya direktori berisi file sungguhan yang tak mau dibuka server mana pun. Bagian berbahayanya: tak ada yang memberi peringatan saat itu terjadi. Penyalinan selesai, exit code nol, dan masalahnya baru terkuak waktu restore — satu-satunya momen yang paling tak sanggup menanggungnya. Karena itulah setiap teknik di artikel ini meminta data store-nya sendiri yang menghasilkan backup: hanya software itu yang tahu kapan file-nya sedang koheren.
Setelah kosakatanya beres, pertanyaan pertama menyusul: perlukah menulis apa pun. Produk backup komersial itu ada, sudah matang, dan membelinya pilihan yang bisa dipertanggungjawabkan. Saya tetap tidak membelinya, karena tiga alasan yang menurut saya berlaku juga di luar situasi saya.
Mahal, dan lisensinya berulang untuk sistem yang logika backup-nya praktis tak berubah lagi begitu ia benar.
Tertutup. Ketika restore gagal pukul tiga pagi, jarak antara membaca kodenya dan mengirim tiket support sama dengan jarak antara memperbaiki dan menunggu.
Dirancang untuk umum, padahal keumuman justru sifat yang keliru di sini. Produk yang wajib melayani semua database melayani database saya secukupnya; script yang cuma melayani database saya melayaninya persis.
Poin ketiga itulah argumen yang sesungguhnya. Tiap aplikasi berbeda tepat pada perkara yang menentukan backup-nya: data store mana yang memegang bagian tak boleh hilang, credential mana yang membuat sistem hasil restore sanggup berfungsi, apa saja yang harus hidup lebih dulu sebelum datanya berarti. Tool umum mustahil mengetahui itu semua, jadi ia menangkap segalanya sambil berharap. Saya lebih memilih menangkap himpunan yang lebih kecil dengan sengaja, dan sanggup menjelaskan alasan tiap barisnya.
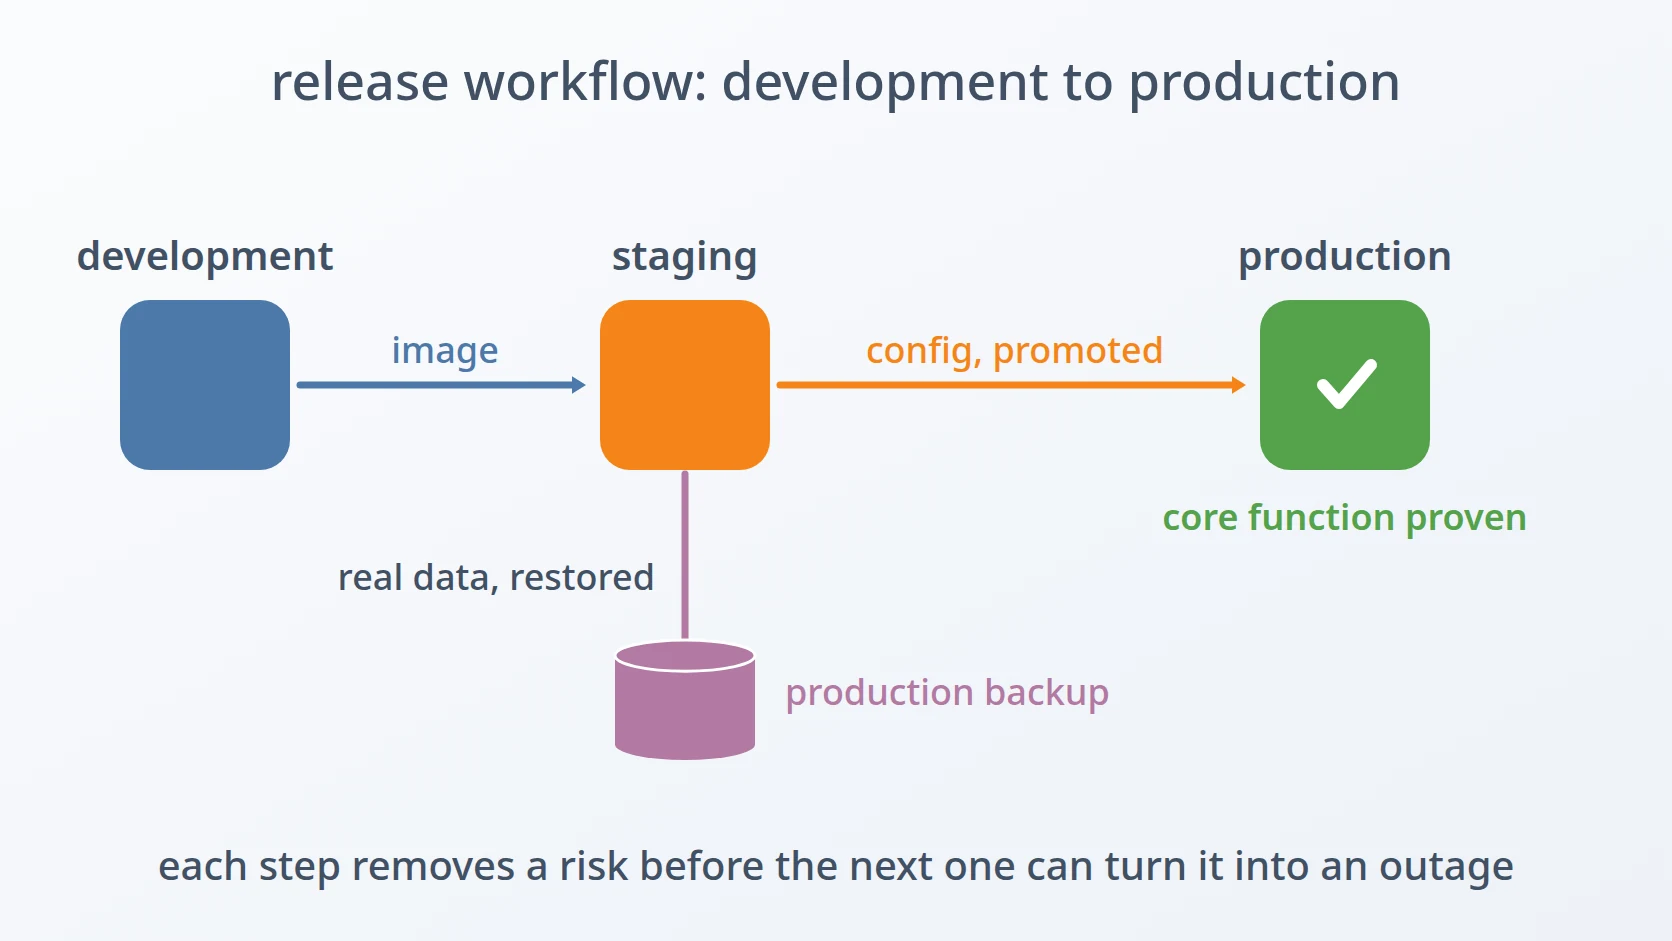
Pertanyaan kedua: backup itu sebenarnya backup atas apa. Naluri pertama menyuruh meng-image seluruh mesin, dan naluri itu salah. Instalasi PostgreSQL saya tidak berharga; ia cuma container image plus empat baris config, bisa dilahirkan ulang semenit dari registry. Yang berharga justru baris-baris data di dalamnya. Begitu pula server object storage dan cluster pencarian — software-nya bisa dibangun ulang, datanya tidak.
Backup datanya, bukan aplikasinya. Aplikasi adalah artefak build. Data satu-satunya bagian sistem yang tak bisa dilahirkan ulang dari mana pun.
Begitu dinyatakan, prinsip itu mengerjakan hampir seluruh desainnya. Dari situ jelas compose file tak perlu ikut masuk, karena sudah tinggal di version control. Jelas pula container image barangkali perlu, sebab restore yang terputus dari jaringan tak sanggup menjangkau registry. Dan dari situ muncul kesimpulan tak nyaman yang paling lama saya tolak: config dan credential itu data, dan backup data tanpa keduanya memulihkan sistem lain, bukan sistem yang tadi di-backup.
B. Empat hambatan yang menghalangi
Jadi sasarannya bukan folder berisi salinan. Sasarannya sebuah rencana yang memenuhi dua angka yang sudah ditetapkan pihak di luar engineering — berapa lama layanan boleh mati, dan berapa banyak pekerjaan terakhir yang boleh hilang — dan yang bisa dibuktikan, bukan sekadar diklaim. Untuk itulah Business Continuity Plan ada, dan itulah standar yang harus dipenuhi.
Gampang dirumuskan, canggung dibangun. Ada empat hambatan yang berdiri antara sasaran tadi dan sistem yang benar-benar memenuhinya, dan masing-masing mementahkan cara yang paling pertama terpikirkan.
Pertama, tiap data store menuntut teknik yang berbeda, dan tak satu pun sudi disalin begitu saja. Backup full merekam keadaan utuh dan berdiri sendiri; incremental hanya merekam yang berubah sejak backup terakhir, dan justru itulah yang membuat jadwal enam jam sekali jadi terjangkau, bukan memberatkan. Cara paling gampang untuk mendapatkan keduanya adalah menyalin direktori datanya, dan pada store yang sedang jalan cara itu menghasilkan backup yang restore-nya berujung korup — file-nya terekam pada saat yang berbeda-beda lalu saling bertentangan. Penggantinya bukan satu teknik melainkan tiga, sebab tiap store menentukan jawabannya sendiri lewat cara ia menulis ke disk. Database berbekal write-ahead log sanggup menyerahkan delta level blok kalau diminta dengan benar. Storage bersegment immutable mendapat incremental nyaris cuma-cuma, sebab segment tak pernah berubah setelah ditulis. Storage tanpa riwayat internal sama sekali tak punya delta untuk ditawarkan, jadi incremental-nya harus disusun dari luar.
Kedua, restore bukan backup yang dibalik urutannya. Bagian inilah yang saya remehkan. Tiap store punya syaratnya sendiri sebelum mau menerima data kembali, dan tak satu pun syarat itu otomatis terpenuhi hanya karena backup-nya sudah dibuat dengan benar. Direktori database hasil rekonstruksi belum tentu database yang mau dinyalakan server; ia butuh penanda yang menyatakan ia sedang apa dan di mana sisanya bisa dicari. Object storage mengembalikan objeknya, tapi tidak aturan siapa yang boleh membacanya. Search cluster menerima kembali dokumennya, dan tetap harus diberi tahu siapa yang berhak menanyainya. Backup yang diperiksa hanya sebatas "sudah tertulis" adalah backup yang diperiksa dari sisi yang keliru.
Ketiga, sistem backup gagal dalam diam kalau dibiarkan. Semua yang di atas boleh saja benar dan tetap tak menghasilkan apa-apa, sebab kegagalan yang lazim di sini bukan crash — melainkan satu langkah yang diam-diam tak berjalan sementara job di sekelilingnya melaporkan sukses. Job yang membungkus tiap langkah dengan || true lalu berakhir dengan kode nol apa pun yang terjadi membuat cron melapor sukses berbulan-bulan padahal ada langkah yang gagal. Melaporkan sukses-atau-gagal saja juga belum cukup, sebab nilai tiap bagian tak sama: menyamakan snapshot telemetri yang hilang dengan dokumen yang hilang cuma melatih orang yang sedang jaga untuk mengabaikan alarmnya.
Keempat, semua itu tak berarti kalau masih menuntut kehadiran saya. Rencana yang bergantung pada seseorang yang harus ingat sudah gagal memenuhi standar yang mengukurnya. Jadwalnya harus jalan tanpa ditunggui, dan scheduler yang tersedia di tiap server juga alat yang tumpul: ia tak sanggup menyatakan bentuk jadwal yang dibutuhkan di sini, dan salah satu bentuk intervalnya berperilaku dengan cara yang diam-diam meninggalkan lubang.
Masing-masing dibahas di seksi tersendiri di bawah, dan urutannya adalah urutan wajib menyelesaikannya. Mengeluarkan datanya dengan benar didahulukan, sebab semua yang menyusul tak ada artinya kalau bagian itu keliru. Memasukkannya kembali adalah pekerjaan tersendiri. Mengetahui apakah keduanya benar-benar terjadi itulah yang membuat dua bagian pertama layak dipercaya. Dan berjalan tanpa ditunggui itulah yang mengubah semuanya dari sekadar prosedur menjadi sebuah rencana.
Metode
Desainnya terdiri dari empat bagian: satu teknik untuk tiap data store, tata letak di disk yang membuat restore point bersifat atomic, retention yang berpatokan pada jumlah full dan bukan pada tanggal, serta schedule yang sungguh-sungguh bisa diungkapkan cron. Urutan itu saya pertahankan karena tiap bagian membatasi bagian sesudahnya.
A. Teknik berbeda untuk setiap data store
Inilah jawaban atas hambatan pertama: tiga store, tiga cara menulis ke disk, jadi tiga teknik yang benar — bukan satu.
Inilah bagian yang paling ingin saya titipkan. Tak ada teknik backup universal. Tiap data store punya satu metode yang benar, ditentukan oleh cara ia menulis ke disk, dan salah memilih metode menghasilkan backup yang tampak berhasil lalu ambruk saat restore — bentuk kegagalan yang paling penting, sebab ia baru ketahuan persis ketika datanya dibutuhkan.
| Data store | Teknik | Kenapa yang ini | Apa yang rusak kalau tidak |
|---|---|---|---|
| PostgreSQL | pg_basebackup, fisik, level blok | Incremental native lewat WAL summarizer; tanpa downtime | pg_dump bersifat logis dan menulis ulang seluruh dataset tiap kali |
| Object storage | mc mirror ke staging, lalu rsync --link-dest | File yang tak berubah jadi hardlink, bukan salinan | Staging kosong yang baru memaksa semuanya diunduh ulang dan linking pun gagal |
| Elasticsearch | Snapshot API ke filesystem repository | Segment Lucene bersifat immutable, jadi snapshot berikutnya cuma menyimpan yang baru | Menyalin data directory yang sedang hidup menghasilkan index korup |
| Config dan credential | Salin biasa, permission dipangkas | Kecil, dan tanpanya datanya tak bisa didekripsi | Ciphertext hasil restore tanpa kunci pembukanya |
PostgreSQL 18 sanggup mengambil backup incremental fisik level blok secara native, dan fiturnya mati sampai dinyalakan. Server-nya harus menjalankan WAL summarizer, yang mencatat blok mana berubah dalam rentang LSN mana; tanpa itu backup incremental langsung menolak jalan. Cuma satu flag, dan komentar di sebelahnya lebih berharga ketimbang flag-nya sendiri.
services:
postgres:
# summarize_wal defaultnya off. pg_basebackup --incremental
# tak bisa jalan tanpanya: tak ada ringkasan WAL, tak ada delta blok.
command: Backup-nya sendiri satu perintah dalam dua bentuk. Full menulis base backup berformat tar; incremental menambahkan --incremental yang menunjuk manifest backup yang jadi dasarnya. Flag-flag pendek itu memuat makna jauh melebihi panjangnya.
# Full
# Incremental: --incremental menunjuk manifest backup sebelumnya
-Ft menghasilkan base.tar dan pg_wal.tar berdampingan dengan backup_manifest. -X stream adalah mekanisme konsistensinya sekaligus alasan downtime tak dibutuhkan: koneksi kedua men-stream WAL yang lahir selama backup berlangsung ke dalam tarball, sehingga hasilnya utuh sendiri dan konsisten secara internal walau database tak pernah berhenti melayani. Saya mengujinya dengan menulis dua juta baris ketika incremental sedang jalan. Hasil restore-nya tetap konsisten.
Restore menyatukan rantainya lewat pg_combinebackup, lalu menuntut satu detail yang gampang lolos dari perhatian: Postgres menolak start dari base backup tanpa file recovery.signal dan restore_command. Ada detail yang lebih halus dan saya menyukainya, karena ia menghapus satu kategori pekerjaan di masa depan. Proses restore membaca PG_VERSION dari dalam backup, lalu menjalankan pg_combinebackup dari container image versi itu, sebab versi tool wajib cocok dengan versi datanya. Backup yang diambil di PostgreSQL 17 tetap bisa di-restore setelah stack hidupnya pindah ke 18, dan tak ada matriks versi yang perlu saya pelihara di mana pun — artefaknya menjelaskan dirinya sendiri.
# Versinya diambil dari backup, bukan dari host: tool PG17 menolak data
# PG18 dan sebaliknya. Artefaknya menjelaskan dirinya sendiri.
pgver=
# Tanpa KEDUA penanda ini Postgres menolak start dari base backup.
B. Restore point ber-hardlink untuk object storage
Object storage tak punya padanan WAL, jadi incremental-nya mesti dibangun, bukan diminta. Saya memakai pola yang dipakai rsnapshot dan Timeshift: dua tahap, tahap kedua membekukan tahap pertama. Tahap pertama memakai mc mirror, perintah dari client MinIO yang menyalin bucket ke folder lokal. Tahap kedua memakai rsync, tool penyalin file, dengan --link-dest: tiap file yang tak berubah sejak restore point sebelumnya menjadi hardlink ke salinan lama itu, bukan salinan baru.
# 1. Tarik keadaan terkini ke SATU staging directory yang persisten
# 2. Bekukan; file yang tak berubah jadi hardlink ke point sebelumnya
--delete itulah yang menjadikannya restore point, bukan tumpukan yang terus membengkak. File yang dibuang dari bucket hari ini lenyap dari point hari ini tapi masih utuh di point minggu lalu, sebab inode-nya — catatan filesystem tentang data sebuah file, yang dipakai bersama oleh semua hardlink ke file itu — bertahan selama masih ada link yang menunjuknya. Semantik point-in-time didapat cuma-cuma dari situ, dan itu pula sebabnya jalur restore wajib mirror balik dengan --remove: tanpa itu yang pulih adalah gabungan seluruh keadaan yang pernah ada, bukan keadaan yang dipilih.
Jebakannya bersembunyi di kata persisten, dan saya sempat terperosok. Kalau tiap run mirror ke direktori kosong yang baru, mc mirror mengunduh ulang seluruh object, tiap file dapat inode dan mtime baru, lalu rsync menyimpulkan tak ada yang cocok — sehingga --link-dest diam-diam menyalin dan bukan me-link. Semuanya tetap jalan. Ongkos disknya saja yang jadi tiga kali lipat. Terukur pada bucket yang sama: tiga restore point memakan 303 MB dengan staging baru, dan sekitar 102 MB dengan staging yang persisten.
Dua batasan lain menggigit tanpa suara. --link-dest menuntut path absolut; path relatif diabaikan tanpa error lalu merosot jadi salinan penuh. Target link-nya pun wajib berada di filesystem yang sama, sebab hardlink tak bisa melintasi batas filesystem. Keduanya menampakkan diri sebagai "backup-nya jalan tapi ukurannya tak wajar", dan keluhan semacam itu tak pernah diselidiki siapa pun dengan segera.
Hardlink juga mengubah arti pemakaian disk. Begitu ia terlibat, du pada satu restore point berhenti melaporkan ongkos point tersebut — sebagian besar byte-nya dipakai bersama. Ruang yang dibebaskan harus diukur sebelum dan sesudah, pada seluruh pohon. Sifat yang sama membuat pemindahan pohon backup jadi berbahaya: rsync -aH atau cp -al mempertahankan link-nya, sedangkan cp -r biasa diam-diam memekarkan tiap link jadi salinan penuh dan sanggup mengubah seratus gigabyte menjadi beberapa ratus.
Ada satu yang sama sekali luput dari salinan tingkat file: policy bucket. mc mirror memindahkan object, bukan policy yang membuat bucket bersifat publik, jadi policy itu disimpan sebagai file JSON berversi dan dipasang ulang saat restore. Restore yang mengembalikan tiap byte tapi meninggalkan seluruh aset publik tak terjangkau bukanlah restore.
C. Snapshot, bukan salinan file, untuk search cluster
Menyalin data directory Elasticsearch yang sedang hidup itu tidak aman, dan ketidakamanannya tak mengumumkan diri. Lucene menulis tanpa henti, segment ber-merge, dan salinan yang terambil di tengah merge bisa cacat secara struktural. Snapshot API lahir justru karena cluster-lah satu-satunya pihak yang tahu kapan file-nya koheren — dan ia incremental secara alami, sebab segment bersifat immutable sehingga snapshot berikutnya cukup merujuk segment yang sudah tersimpan.
Filesystem repository didaftarkan sekali saja. Dari mana ia di-mount ternyata lebih menentukan daripada kelihatannya.
Repository-nya di-mount ke dalam container dari backup root, sengaja bukan dari folder state milik environment. Andai ia tinggal bersama data environment, membongkar environment itu berarti memusnahkan backup yang seluruh tujuannya justru bertahan dari peristiwa tersebut. Poinnya terdengar terang benderang tapi gampang dilanggar, sebab mem-mount-nya di samping data memang lebih praktis.
Karena segment dipakai bersama antar-snapshot, menyalin repository ke setiap restore point akan meniadakan sifat incremental-nya sama sekali. Maka tiap restore point hanya menyimpan nama snapshot dalam file teks kecil, sementara repository-nya dipakai bersama oleh semua point. Itu konsekuensi langsung desain incremental: restore point-nya penunjuk, bukan salinan.
Elasticsearch juga akan menonaktifkan repository bila isinya tak lagi cocok dengan ingatan cluster, disertai laporan bahwa repository dimatikan demi mencegah korupsi data. Kuncian itu tak lepas sendiri; registrasinya harus dihapus lalu dibuat ulang. Script-nya menyembuhkan diri tepat sekali, sesudah itu menyerah. Batas tersebut disengaja — loop percobaan ulang yang mengitari penjaga korupsi cuma cara memusnahkan data dengan antusias.
D. Config dan credential adalah bagian dari data
Masih hambatan pertama, diperluas melampaui store-nya sendiri: memulihkan data tanpa kunci yang membuatnya terbaca sama saja memulihkan kumpulan byte, bukan sistemnya.
File .env dan pohon config/ tiap modul disalin ke dalam restore point, lalu permission group dan other-nya dipangkas.
Kelihatannya cuma kerapian, padahal bukan. Aplikasinya mengenkripsi kolom database yang sensitif memakai application key yang tersimpan di config. Restore database tanpa kunci itu, dan yang pulih cuma ciphertext yang selamanya tak akan bisa dibuka siapa pun, saya sekalipun. Backup database, berdiri sendirian, tak bernilai apa-apa. Satu contoh itu mengubah cara saya memikirkan batas backup: batasnya bukan data store, melainkan segala yang dibutuhkan agar datanya kembali bisa dipakai.
Beberapa hal sengaja dikecualikan. Compose file dan config nginx tidak di-backup, sebab keduanya hidup di version control dan dirender dari template. Cerita pemulihannya adalah "clone repository", dan itu cerita yang lebih meyakinkan ketimbang salinan apa pun yang sanggup saya ambil. Mengetahui apa yang sengaja tidak di-backup, berikut alasannya, sama pentingnya dengan sisa desainnya.
E. Tata letak, atomicity, dan path yang tak bergantung pada tempat berdiri
Semuanya mendarat di bawah satu backup root per project, dengan restore point dinamai sedemikian rupa sehingga urutan leksikalnya sama dengan urutan kronologisnya, ditambah symlink latest yang relatif.
Restore point diterbitkan secara atomic. Seluruh pekerjaan berlangsung di direktori tersembunyi berawalan .tmp-, dan baru dipindahkan ke tempatnya setelah semua langkah berhasil. Karena pemindahan di dalam satu filesystem hanyalah rename, backup yang mati di tengah jalan — listrik padam, dibunuh OOM, deploy yang buruk — mustahil menjelma jadi restore point yang sah. Yang tertinggal cuma puing bernama aneh yang terurut menyingkir, dan itu hasil yang benar.
Path-nya sendiri diturunkan dari nama project, bukan dari direktori kerja saat itu. Versi sebelumnya menanamkan path absolut repository, dan punya dua mode kegagalan yang baru saya pahami setelah kena keduanya: mengganti nama atau memindahkan repository diam-diam memutuskannya dari datanya sendiri, lalu environment yang sama ternyata berbeda path-nya di laptop dan di server. Menurunkan path dari nama membuatnya identik di mana pun, sekaligus memungkinkan /data dan /backup di-mount pada disk terpisah tanpa menyunting satu pun compose file.
Pemisahan itu yang pertama dari tiga sifat yang hendak dibuka tata letak ini. Backup layak menempati direktorinya sendiri, idealnya disknya sendiri, karena justru dari situ sisanya jadi mungkin dikerjakan: disk bisa di-mirror, direktori bisa disalin keluar mesin, pohonnya bisa dienkripsi sebelum berangkat. Desain yang memenuhi Business Continuity Plan menuntut ketiganya sekaligus — media terpisah, salinan di luar lokasi, dan enkripsi sebelum transfer — sedangkan tata letak yang mengandaikan backup tinggal bersebelahan dengan data menjadikan tiap-tiapnya penulisan ulang, bukan penambahan.
F. Retention dan schedule yang bisa diungkapkan cron
Inilah jawaban atas hambatan keempat: berjalan tanpa ditunggui, di atas scheduler yang cukup tumpul sampai perlu disiasati.
Retention-nya berbunyi "simpan N full", bukan "hapus apa pun yang lebih tua dari X hari". Alasannya rantai ketergantungan: incremental tak berarti tanpa full induknya, jadi incremental disimpan dan dihabiskan bersama full yang menaunginya, sebagai satu kesatuan. Aturan berbasis tanggal sanggup menghapus satu full sementara anak-anaknya bertahan, dan yang tertinggal adalah direktori yang menyerupai backup tapi tak me-restore apa pun. Production menyimpan dua.
Rotation juga tersedia sebagai job tersendiri, bukan cuma langkah penutup di akhir backup. Perbedaannya terdengar akademis sampai backup mulai gagal: kalau rotation cuma jalan sesudah backup berhasil, maka saat backup rusak adalah saat ruang berhenti dibebaskan — dan disk penuh merupakan cara yang amat manjur untuk menjamin backup berikutnya ikut gagal.
Urutan penghapusan menentukan di satu tempat. Snapshot Elasticsearch wajib dihapus lewat API sebelum folder restore point dibuang, sebab nama snapshot-nya justru menghuni folder yang hendak dihapus itu. Saya pernah membaliknya sekali dan menelantarkan sembilan snapshot di repository bersama, yang menahan segment untuk restore point yang sudah tiada.
# Urutan menanggung beban: namanya ada di dalam folder itu
name=
Schedule-nya dua baris cron: full tiap Minggu tengah malam, incremental tiap enam jam kecuali pada saat itu. Butuh dua baris karena cron tak sanggup mengungkapkan "tiap enam jam kecuali Minggu 00:00" dalam satu ekspresi, dan berpura-pura sanggup cuma melahirkan full dan incremental yang berlomba tiap pekan.
# Full: tiap Minggu 00:00 — pakai day-of-week, jangan */7 di day-of-month
# Incremental: tiap 6 jam, melewati slot yang ditempati full
Komentar soal */7 merekam jebakan yang layak dikenali. Di field day-of-month, */7 menghasilkan tanggal 1, 8, 15, 22, dan 29 — lalu mengulang dari awal begitu bulan berganti. Jarak dari 29 September ke 1 Oktober cuma dua hari, bukan tujuh. Day-of-week selalu tepat tujuh hari, dan itulah makna yang seharusnya dibawa kata "mingguan".
Hasil dan Pembahasan
A. Dua kegagalan yang bakal tampak seperti keberhasilan
Pelajaran paling berharga dari project ini: sistem backup gagal secara senyap kalau dibiarkan, jadi saya merancang penangkal untuk dua kegagalan yang bisa tak terlihat selama berhari-hari.
Yang pertama bersarang di incremental PostgreSQL. Demi kecepatan, manifest dasarnya di-cache di dalam container. Begitu rotation menghapus satu full lama, cache yang dipercaya begitu saja akan terus menunjuk manifest milik backup yang sudah tiada. Setiap incremental sesudahnya tetap jalan, melapor berhasil, dan melahirkan file yang berdiri di atas dasar yang keliru. Tak ada yang protes. Kegagalannya baru menyembul saat restore, berupa ketidakcocokan LSN.
Penangkalnya kecil: bandingkan Start-LSN manifest yang di-cache dengan yang ada di disk pada setiap run, lalu salin ulang bila berbeda. Prinsipnya jauh lebih besar, dan inilah yang akan saya bawa ke sistem mana pun. Kebenaran incremental bergantung pada state yang hidup di luar backup itu sendiri. Apa pun yang di-cache tentang state tersebut merupakan klaim tentang dunia, dan klaim wajib diverifikasi ulang, bukan diingat.
Kegagalan kedua lebih buruk, sebab datanya tak pernah terancam dan sistemnya tampak sehat sepanjang waktu. Men-snapshot index telemetri saja terasa jelas benar — di situlah dokumennya — dan restore dari snapshot semacam itu memang mengembalikan setiap dokumen. Yang tak ikut pulang adalah index .security berisi user dan role yang dipakai log exporter untuk autentikasi, sehingga exporter ditolak dengan 401 pada tiap ekspor dan membuang telemetrinya tanpa suara, sementara stack-nya kelihatan baik-baik saja.
Menyertakan .security* menutup celah itu, sementara include_global_state ikut membawa index template beserta policy ILM yang membuat index baru berperilaku benar. Prinsipnya: mem-backup dokumen saja tidak cukup. State otorisasi yang menjaga para penulis tetap sanggup menulis wajib ikut di-backup — kalau tidak, yang pulih adalah sistem yang bisa dibaca, utuh, dan tak sanggup menerima apa pun yang baru.
B. Exit code sebagai pernyataan tentang nilai
Inilah jawaban atas hambatan ketiga: membuat kegagalan yang membisu mustahil disalahartikan sebagai sukses.
Membungkus tiap langkah dengan || true lalu keluar dengan kode nol apa pun yang terjadi akan membuat cron melapor berhasil berbulan-bulan sementara langkah-langkahnya gagal satu per satu. Itu desain paling buruk yang bisa dibayangkan, sebab ia mengubah sistem pemantauan menjadi sistem penenang hati.
Penggantinya menyandikan tingkat keparahan, bukan keberhasilan, karena tidak semua bagian sistem bernilai sama.
| Exit code | Artinya | Backup-nya sah untuk restore? |
|---|---|---|
0 | Semua komponen tertangkap | Ya |
1 | PostgreSQL atau object storage gagal | Tidak — jangan percayai point ini |
2 | Hanya Elasticsearch yang gagal | Dokumen aman; telemetri tidak |
Penalarannya: dokumen bertanda tangan dan data observabilitas tidak bernilai sama, dan melaporkan keduanya sebagai kegagalan yang seragam cuma melatih petugas jaga untuk mengabaikan alarmnya. Alarm yang berbunyi untuk keduanya berakhir dibisukan, dan alarm yang dibisukan lebih buruk daripada ketiadaan alarm — ia menduduki tempat yang seharusnya diisi alarm yang bekerja.
Ada satu pemeriksaan lagi, dan ia ada justru karena betapa buruknya alternatifnya. Script-nya menghitung apa yang benar-benar tertangkap lalu gagal bila nol database ter-backup. Backup "berhasil" yang isinya kosong merupakan hasil terburuk dalam seluruh desain ini: ia memuaskan tiap monitor, memakan slot retention, dan mendorong backup sungguhan yang terakhir makin dekat ke penghapusan.
C. Apa yang dikatakan angkanya, dan apa yang tidak
Hasil terukurnya sederhana dan saya ingin menyebutnya dengan tepat. Restore tiga database memakan sekitar tujuh detik downtime. Hardlink menurunkan tiga restore point object storage dari 303 MB ke sekitar 102 MB. Rantai incremental-nya berjalan di cron pada production, dan sudah berjalan tanpa campur tangan.
Image Docker diekspor berdampingan dengan datanya, dan cuma di situlah saya sengaja mem-backup benda yang sebetulnya bisa dibangun ulang. Restore data merekonstruksi state; image-nya menjaga kode yang tahu cara menafsirkan state tersebut. Lagi pula restore yang benar-benar terputus dari jaringan tak sanggup menarik apa pun dari registry — padahal skenario itulah yang melahirkan rencana ini, sehingga mengandaikan akses jaringan justru menggagalkan tujuannya sendiri.
Tujuh detik itu mengukur satu hal: data yang di-restore ke mesin yang sudah bekerja. Membangun ulang setelah kebakaran — mendapatkan kembali mesin, jaringan, dan sertifikat — adalah bagian lain dari rencana yang sama, dengan ukuran waktunya sendiri. Nilai restore yang ter-script terletak pada perpindahan porsi data dari tak diketahui menjadi diketahui, sehingga sisa ketidaktahuannya tampak di permukaan dan tidak tersembunyi di balik andaian.
D. RTO dan RPO, dinyatakan
Sebagai solution architect, saya lebih suka menutup desain dengan dua angka yang tertulis daripada dengan perasaan bahwa backup-nya beres. Untuk sistem ini, keduanya langsung keluar dari schedule dan hasil ukur di atas.
| Sasaran | Yang dipenuhi rencana ini | Asalnya |
|---|---|---|
| RPO (berapa banyak data terakhir yang boleh hilang) | Paling lama enam jam | Incremental jalan setiap enam jam di atas full mingguan, jadi restore point terbaru tak pernah lebih tua dari satu interval. |
| RTO untuk data (restore ke mesin yang masih hidup) | Sekitar tujuh detik downtime untuk ketiga database | Diukur dari restore sungguhan, bukan perkiraan. |
| RTO bila mesinnya hilang | Tidak dinyatakan sebagai satu angka | Mendapatkan kembali mesin, jaringan, dan sertifikat adalah bagian rencana yang terpisah, dengan waktunya sendiri. |
Mengetatkan salah satu angka itu adalah keputusan biaya, bukan keputusan teknis. RPO yang lebih pendek berarti incremental lebih sering; RTO yang lebih pendek saat mesin hilang berarti menyiagakan mesin kedua. Menuliskan angkanya membuat pertukaran itu bisa benar-benar diputuskan oleh orang yang membayarnya.
Simpulan
Kalau harus menyimpan satu kalimat dari semua ini: backup adalah klaim tentang masa depan yang hanya sekali seumur hidup diuji. Selebihnya menyusul dari situ — bahwa ujiannya wajib restore sungguhan dan bukan exit code yang berhasil; bahwa exit code-nya wajib membedakan jenis kegagalan; dan bahwa backup yang tak menangkap apa pun wajib diperlakukan sebagai kegagalan, bukan keberhasilan.
Detail teknis yang pertama akan saya titipkan menyangkut config. Menggoda sekali memperlakukan file .env dan material kunci sebagai kerapian administratif yang kebetulan duduk di sebelah backup yang sesungguhnya, dan cara pandang itulah yang melahirkan restore yang tak bisa dipulihkan. Kalau aplikasi mengenkripsi kolom dengan sebuah kunci, kunci itu bukan config — ia bagian dari data, dan memisahkan keduanya meninggalkan ciphertext tanpa masa depan. Batas backup bukan data store. Batasnya adalah segala yang dibutuhkan agar data itu kembali bermakna.
Tak satu pun dari ini bergantung pada stack saya. PostgreSQL, MinIO, dan Elasticsearch kebetulan yang saya pakai; metodenya justru yang bertahan andai ketiganya diganti. Tanyakan kepada tiap data store bagaimana ia menulis ke disk, lalu biarkan jawabannya memilihkan tekniknya — database berbekal write-ahead log sanggup menyerahkan delta level blok, storage bersegment immutable sudah incremental cuma-cuma, dan storage tanpa riwayat internal menuntut restore point-nya disusun sendiri dengan sesuatu semacam hardlink. Pertanyaannya tak pernah "tool apa yang mem-backup ini", melainkan "apa yang dijamin benda ini tentang file-nya sendiri, dan kapan".
Sisanya adalah penataan. Terbitkan restore point secara atomic supaya kegagalan di tengah jalan tak sanggup melahirkan point yang tampak meyakinkan. Turunkan path dari nama dan bukan dari lokasi, supaya pohon backup bisa pindah ke disknya sendiri tanpa menyunting apa pun. Simpan berdasarkan rantai ketergantungan dan bukan tanggal, supaya tak ada incremental yang terpisah dari induknya. Taruh backup di media terpisah, salin ke tempat lain, dan enkripsi sebelum ia meninggalkan mesin — Business Continuity Plan yang merasa backup-nya aman karena berada di server yang sama belum merencanakan peristiwa yang paling mungkin mengujinya.
Dan tulislah sendiri, bila sistemnya cukup kecil untuk itu. Bukan karena produk komersialnya buruk, melainkan karena backup satu-satunya bagian infrastruktur yang nilainya sepenuhnya terletak pada apakah ia bekerja di hari terburuk sepanjang tahun. Beberapa ratus baris yang bisa saya baca dari ujung ke ujung, yang gagal dengan berisik dan me-restore dalam tujuh detik, memberi saya keyakinan lebih besar ketimbang produk yang menangani setiap kasus termasuk, konon, kasus saya.
Istilah
- Business Continuity Plan
- Kumpulan langkah terdokumentasi yang menjaga kewajiban sistem tetap bisa dipenuhi setelah kegagalan; backup dan restore salah satu bagiannya, bukan keseluruhannya.
- Recovery Time Objective (RTO)
- Waktu terlama sebuah layanan boleh tak tersedia setelah kegagalan sebelum menjadi tak bisa diterima, yang menentukan seberapa cepat restore harus selesai.
- Recovery Point Objective (RPO)
- Jumlah data terbaru terbanyak yang boleh hilang saat kegagalan, diukur sebagai waktu sejak restore point terakhir, yang menentukan seberapa sering backup harus jalan.
- WAL summarizer
- Proses latar PostgreSQL yang mencatat blok mana berubah dalam rentang LSN mana, sehingga backup incremental level blok menjadi mungkin. Mati secara default.
- LSN
- Log Sequence Number: posisi di dalam write-ahead log PostgreSQL, dipakai untuk memastikan backup incremental menyambung tepat di tempat induknya berhenti.
- Hardlink
- Entri direktori kedua yang menunjuk inode yang sudah ada. Data file-nya hanya ada satu dan bertahan sampai seluruh link ke sana dihapus, dan itulah yang memungkinkan file tak berubah dipakai bersama antar restore point tanpa biaya.
- Restore point
- Direktori yang mewakili keadaan lengkap sistem pada satu momen, termasuk file yang telah dihapus sejak point sebelumnya, berbeda dari salinan yang terus menumpuk.
- Atomic publish
- Merakit pekerjaan di bawah nama sementara dan baru me-rename-nya ke tempatnya saat berhasil, sehingga operasi yang terputus tak bisa meninggalkan hasil separuh jadi yang tampak lengkap.
Technologies covered
- Bash
- Linux
- Elasticsearch
- PostgreSQL
- Docker