Bagaimana Saya Memusatkan Logs, Traces, dan Metrics pada Sistem Multi-Service
On this page
- Pendahuluan
- A. Apa sebenarnya ketiga tools ini, dan kenapa masing-masing ada
- B. Lima hambatan yang menghalangi
- Metode
- A. Satu titik pengumpulan, dan collector yang tak berbuat pintar-pintar
- B. Restart yang selalu memakan menit-menit pertama
- C. Dua jebakan yang saya catat supaya tak terulang
- D. Instrumentation: tiga bahasa, satu bentuk
- E. Propagation: bagaimana satu transaksi tetap satu transaksi
- F. Batas-batas yang bukan HTTP
- Hasil dan Pembahasan
- A. Untuk apa logs, setelah traces ada
- B. Event audit yang tersimpan dua kali
- C. Metrics, dan ongkos satu label yang ceroboh
- D. Storage, mapping, dan template yang bisa mematahkan metrics saja
- E. Membacanya: data view, satu runtime field, dan dashboard sebagai artefak
- Simpulan
- Istilah
Sistem yang berjalan sebagai satu proses hanya punya satu tempat untuk diperiksa. Pasang debugger, tail satu file, dan pertanyaan "di mana ini terjadi" tak pernah muncul karena jawabannya memang cuma satu. Pecah aplikasi yang sama ke belasan container, dan pertanyaan itu berubah jadi yang paling mahal. Seorang user melapor penandatanganan dokumen gagal. Gagalnya di suatu titik antara gateway, API, service penandatangan, dan dua otoritas eksternal — masing-masing mencatat sesuatu secara lokal, untuk dirinya sendiri, dengan formatnya sendiri.
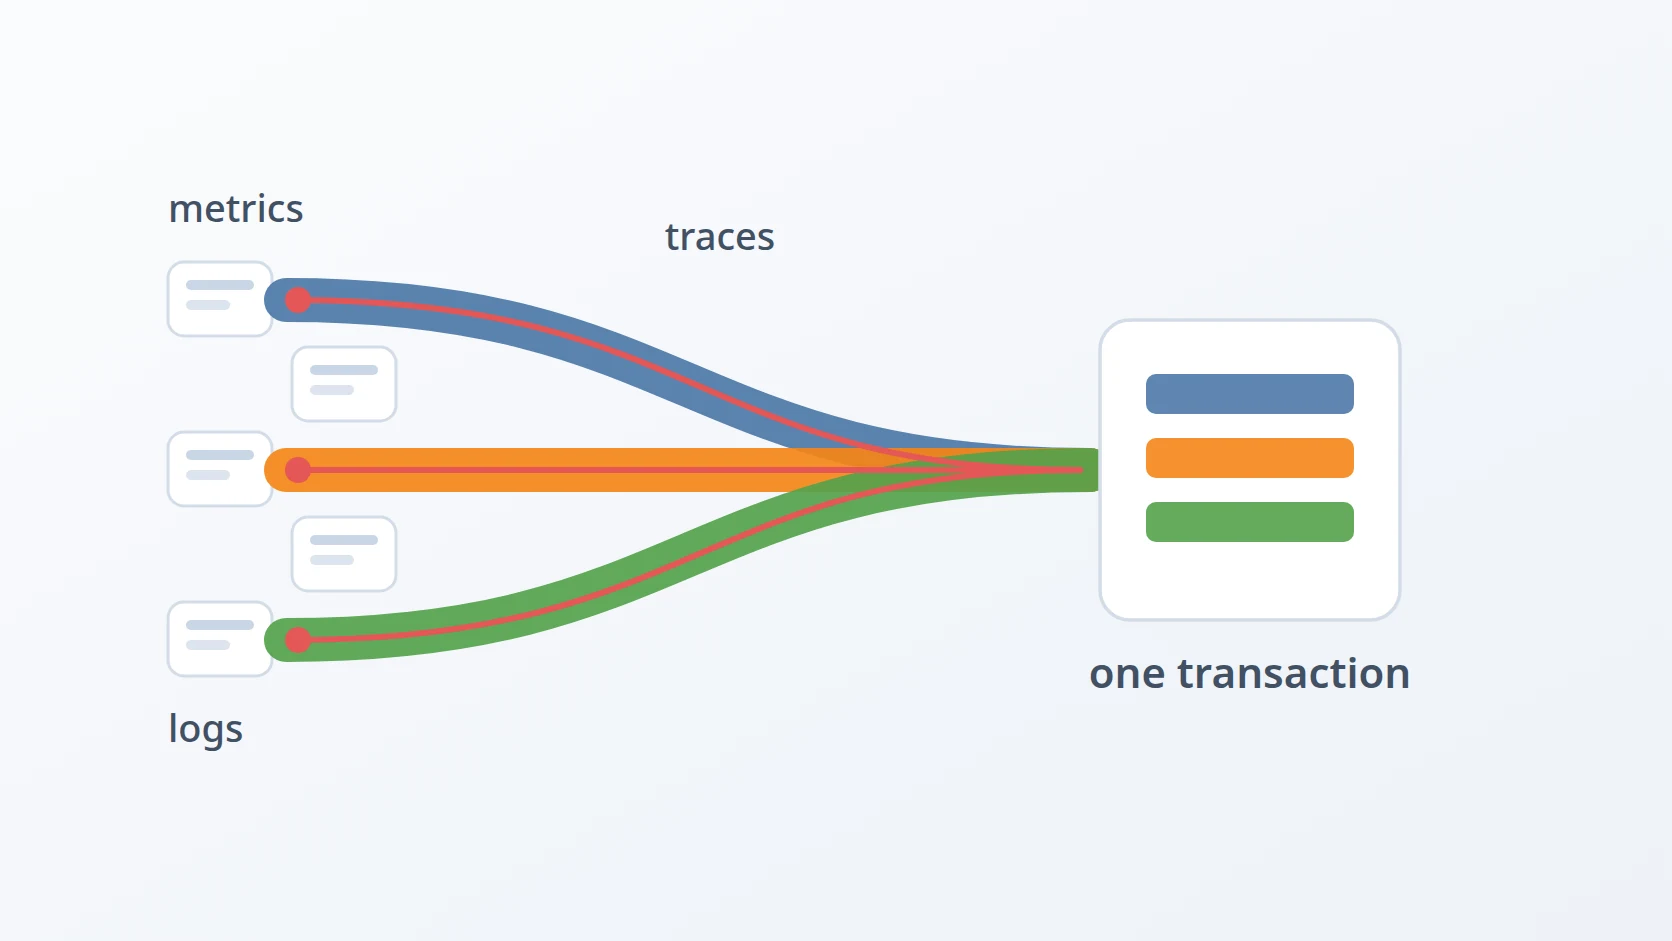
Yang saya butuhkan saat itu bukan log yang lebih banyak, melainkan kemampuan mengambil satu identifier lalu menyusun ulang satu transaksi melintasi setiap service yang dilewatinya, berurutan, lengkap dengan durasi. Itu persoalan lain sama sekali dari logging, dan membangunnya mengubah cara saya menulis instrumentation. Artikel ini tentang bentuk itu — satu titik pengumpulan, tiga signal yang saling bersesuaian — dan tentang kegagalan yang mengajari saya lebih banyak daripada rancangannya sendiri.
Pendahuluan
Naluri pertama ketika log berserakan adalah memusatkan log, lalu berhenti di situ. Saya pernah menempuhnya, dan hasilnya jauh lebih sedikit dari yang dijanjikan. Setiap baris dari setiap container memang berkumpul di satu tempat yang bisa dicari, dan itu perbaikan nyata, tapi pertanyaan yang jadi alasan membangunnya tetap tak terjawab. Seribu baris dari lima service yang saling menyela tidak berubah menjadi satu transaksi hanya karena berbagi satu layar.
Sebelum melangkah lebih jauh, tiga kata perlu diperjelas dulu, sebab ketiganya menanggung sebagian besar beban artikel ini dan tidak bisa saling menggantikan. Log adalah baris teks yang ditulis program untuk menyatakan apa yang baru saja ia lakukan. Trace adalah rekaman perjalanan satu request melintasi sistem, tersusun dari span yang bersarang — span sendiri adalah satu operasi bernama yang punya waktu mulai, durasi, dan induk. Metrics adalah angka yang diambil berkala sepanjang waktu, misalnya berapa request masuk pada menit ini dan berapa lama masing-masing berjalan.
Yang hilang bukan volume, melainkan struktur. Tepatnya tiga potong struktur, yang persis sejajar dengan tiga signal yang didefinisikan OpenTelemetry — standar terbuka, dengan library untuk kebanyakan bahasa, tentang cara program mencatat logs, traces, dan metrics lalu mengirimkannya keluar — dan yang kini saya pandang sebagai jawaban atas tiga pertanyaan berbeda, bukan tiga format untuk data yang sama.
Traces menjawab request ini lewat mana saja, dan apa yang memakan waktu. Inilah struktur sebab-akibatnya: pohon operasi, tiap simpul punya induk, tiap simpul punya awal dan durasi.
Logs menjawab apa yang diputuskan kode, dan mengapa. Inilah narasi yang tak sanggup dibawa trace — cabang mana yang diambil, validasi mana yang gagal, identifier record mana yang terlibat.
Metrics menjawab apakah ini normal. Hanya signal inilah yang menggambarkan sistem, bukan satu request, dan hanya ini pula yang cukup murah untuk disimpan utuh selamanya.
Tak ada yang bisa menggantikan yang lain. Trace tanpa log memperlihatkan satu span menghabiskan empat detik, tapi bungkam soal apa yang ditunggunya. Log tanpa trace memperlihatkan apa yang terjadi, tanpa menempatkannya sebagai bagian dari apa. Metrics menunjukkan error rate naik tiga kali lipat, tapi tak menyodorkan satu pun contoh untuk diperiksa. Nilainya tidak terletak pada salah satunya; nilainya terletak pada kenyataan bahwa ketiganya bisa disambungkan kembali.
Tiga signal bukan tiga cara memandang satu sistem. Ketiganya tiga pertanyaan berbeda, dan rancangannya tak bernilai apa-apa kalau jawabannya tak bisa disambungkan kembali.
Penyambungannya dikerjakan satu field. Tiap log record membawa identifier trace dan span dari operasi tempat ia dipancarkan; tiap metric membawa resource attribute yang sama dengan span dari service yang sama. Ambil satu identifier trace, cari di tampilan traces, cari juga di tampilan logs, dan transaksinya tersusun kembali. Korelasi tunggal itulah inti dari seluruh isi artikel ini.
A. Apa sebenarnya ketiga tools ini, dan kenapa masing-masing ada
Stack yang mengerjakan semua ini terdiri dari tiga bagian, dan sebaiknya dijelaskan dulu apa masing-masingnya sebelum bicara bagaimana ketiganya dirangkai — nama-nama itu terlalu sering dipakai seolah semua orang sudah paham. Tak ada yang misterius pada ketiganya; masing-masing menyelesaikan satu persoalan spesifik yang tak diselesaikan dua lainnya.
Elasticsearch adalah mesin pencari yang menyimpan dokumen dan meng-index setiap field di dalamnya. Pilihan yang ganjil untuk telemetry, sampai kita ingat apa yang sebenarnya dilakukan terhadap telemetry: nyaris tak pernah dibaca berurutan, melainkan dicari. Yang dibutuhkan misalnya seluruh record dari satu service dalam jendela lima menit dengan status 500, diurutkan menurut durasi. File biasa tak bisa menjawab itu tanpa membaca semuanya; basis data relasional bisa, tapi kolomnya harus diputuskan di muka, padahal atribut telemetry berbeda-beda antar service dan bertambah setiap kali seorang developer menambahkannya. Elasticsearch meng-index field apa pun yang datang, dan bentuk itulah yang dibutuhkan persoalan ini.
OpenTelemetry Collector adalah proses kecil yang menerima telemetry dari aplikasi lalu meneruskannya ke store. Pertanyaan yang wajar: kenapa ia perlu ada, kalau tiap service bisa menulis langsung ke Elasticsearch. Ia ada karena susunan langsung itu menaruh password storage di setiap service, membebani setiap service urusan retry ketika store mati, dan membuat penggantian backend storage menuntut perubahan dan deploy ulang setiap aplikasi. Dengan collector di tengah, tiap service cukup tahu satu alamat dan satu protokol. Sisanya config file di satu tempat.
Kibana adalah permukaan baca untuk Elasticsearch: ia mengubah query menjadi tabel, grafik, dan dashboard. Ia ada karena alternatifnya adalah mengetik query pencarian dengan tangan — masih sanggup sekali dua kali, tak tertahankan saat insiden. Menariknya, hanya Kibana dari ketiganya yang pernah dibuka manusia, dan itu penting nanti: postur keamanan bidang baca adalah persoalan yang berbeda dari postur keamanan pipeline-nya.
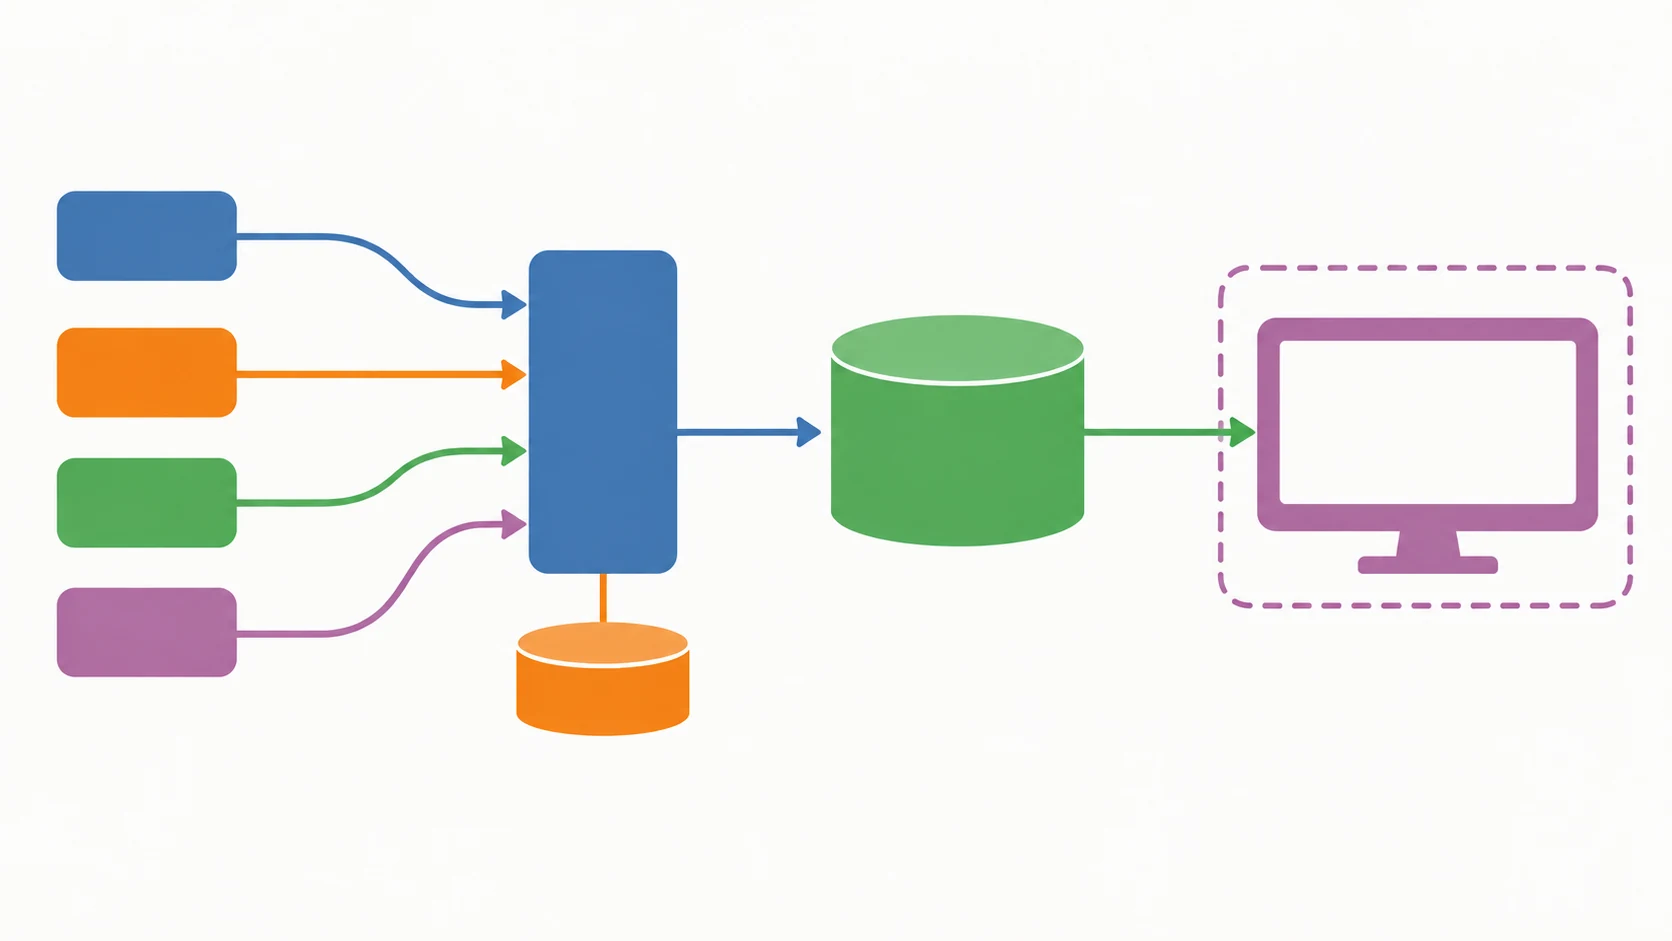
Dirangkai: aplikasi mem-push telemetry ke collector, collector meneruskannya ke Elasticsearch, dan Kibana tempat kita membacanya. Sisa artikel ini membahas keputusan-keputusan di dalam kalimat tadi.
B. Lima hambatan yang menghalangi
Yang saya inginkan dari semua ini muat dalam satu kalimat. Ambil satu identifier dari keluhan seorang user, lalu susun kembali seluruh transaksi yang memuatnya — tiap service yang dilewatinya, berurutan, lengkap dengan durasi dan keputusan yang diambil masing-masing. Dengan dua batasan yang ternyata lebih menentukan ketimbang tujuannya sendiri: tanpa menyuruh developer menyelipkan apa pun di tiap call site kodenya, dan tanpa telemetry-nya sendiri berubah jadi beban yang sanggup menjatuhkan apa yang ia awasi.
Gampang dirumuskan, canggung dibangun. Ada lima hambatan yang berdiri antara kalimat itu dan sistem yang benar-benar memenuhinya, dan tak satu pun memperkenalkan diri sebagai persoalan desain. Ketiganya menyamar jadi hal lain — satu pesan yang sudah lama tak saya baca, satu angka yang kelihatan wajar, satu komponen yang terus saja bekerja.
Hambatan pertama: restart bisa diam-diam memakan menit-menit pertama telemetry. Bukan mati, bukan error — cuma tak ada, justru pada saat saya paling mungkin sedang menonton. Ketegangannya: sebuah collector tak boleh menahan data selamanya, tapi juga tak boleh membuangnya, dan setelan bawaannya memutuskan ketegangan itu ke arah membuang. Cukup dua hal benar bersamaan: jendela retry yang habis sebelum store selesai siap, dan queue penampung data yang cuma hidup di memory. Pengaman yang paling kelihatan justru tak berbuat apa-apa di sini — health condition pada depends_on di compose file betul-betul ditegakkan dan betul-betul percuma, sebab yang ia laporkan adalah container sudah mulai lolos health check, bukan service di belakangnya sudah mau menerima tulisan. Godaan kedua adalah melebarkan jendela retry saja, dan itu cuma akan menutupi balapan startup yang satu ini sambil membiarkan outage yang lebih panjang tetap sama merusaknya.
Hambatan kedua: event audit bisa tersimpan dua kali tanpa ada yang gagal. Menulis tiap event audit dalam dua rupa sekaligus — sebagai log record, dan sebagai event yang menempel pada span aktif — kelihatan seperti bersabuk sekaligus bertali, padahal itu cacat kebenaran: span event tidak mendarat di data stream traces, melainkan di data stream logs, tepat bersebelahan dengan log record biasanya. Dua dokumen untuk satu kejadian, berselisih satu milidetik, dan tak satu pun menandai dirinya salinan yang lain. Jejak audit itu sebuah klaim tentang berapa kali sesuatu terjadi, jadi mekanisme yang sanggup melipatgandakan barisnya diam-diam bukan soal kerapian, melainkan soal benar atau salah. Alternatif yang harus saya lepas justru yang paling nyaman: biarkan dua-duanya menulis, lalu dedup saat membaca — dan bebannya berpindah ke tiap query di masa depan, bukan ke satu tempat yang memancarkannya.
Hambatan ketiga: index template buatan sendiri bisa menimpa mapping resmi tanpa suara. Template yang cukup luas untuk menjangkau index telemetry ikut mencocoki — dan menggantikan — mapping yang dipasang exporter untuk dirinya sendiri. Semuanya tetap jalan kecuali metrics, satu-satunya signal yang cukup ketat soal tipe field sehingga mau protes; akibatnya satu salah konfigurasi menampakkan diri sebagai gangguan pada satu signal, bukan sebagai kerusakan yang mengenai ketiganya. Alternatifnya adalah membiarkan bawaan apa adanya tanpa template sama sekali, dan itu berarti melepas setelan yang memang hak saya untuk memilih.
Hambatan keempat: satu transaksi berhenti menjadi satu transaksi di tiap batas yang tak punya pasangan request dan response untuk menumpangkan header. Trace ada semata-mata karena tiap service memberi tahu service berikutnya ia bagian dari trace mana, dan serah terima itu wajib di-inject tiap pemanggil serta di-extract tiap penerima. Lewatkan satu paruhnya saja di satu hop, dan tak ada yang error — trace-nya membelah diam-diam jadi dua trace tak berhubungan, masing-masing tampak utuh kalau dilihat sendiri-sendiri. Batas yang mematahkannya justru yang sama sekali tak punya pasangan request-response: message queue yang consumer-nya mencocokkan satu tipe string tertentu lalu mengabaikan tipe lain tanpa bersuara, background job yang menyeberangi batas waktu alih-alih batas ruang, dan worker thread yang meninggalkan context-nya di thread-local storage. Alternatif yang harus saya coret justru yang kelihatan tak berbahaya — memformat header trace dengan tangan ketimbang lewat propagator SDK, yang bekerja sampai hari ketika formatnya bertambah satu field.
Hambatan kelima: satu label yang ceroboh menggerogoti store, bukan kodenya. Metric yang dilabeli path request mentah, bukan template route, melahirkan satu time series baru untuk tiap URL yang berbeda — situs dengan sepuluh ribu artikel berarti sepuluh ribu time series untuk satu instrumen saja. Tak ada yang gagal; store-nya cuma makin lambat dan makin besar sampai ada yang menyelidikinya. Alternatif yang ditolak adalah melabelinya dengan path apa adanya, dengan alasan ia membawa lebih banyak keterangan — memang betul, dan keterangan itu tak ada gunanya pada cardinality setinggi itu, sebab tak ada query yang bisa mengelompokkan berdasarkan dimensi yang tak pernah berulang.
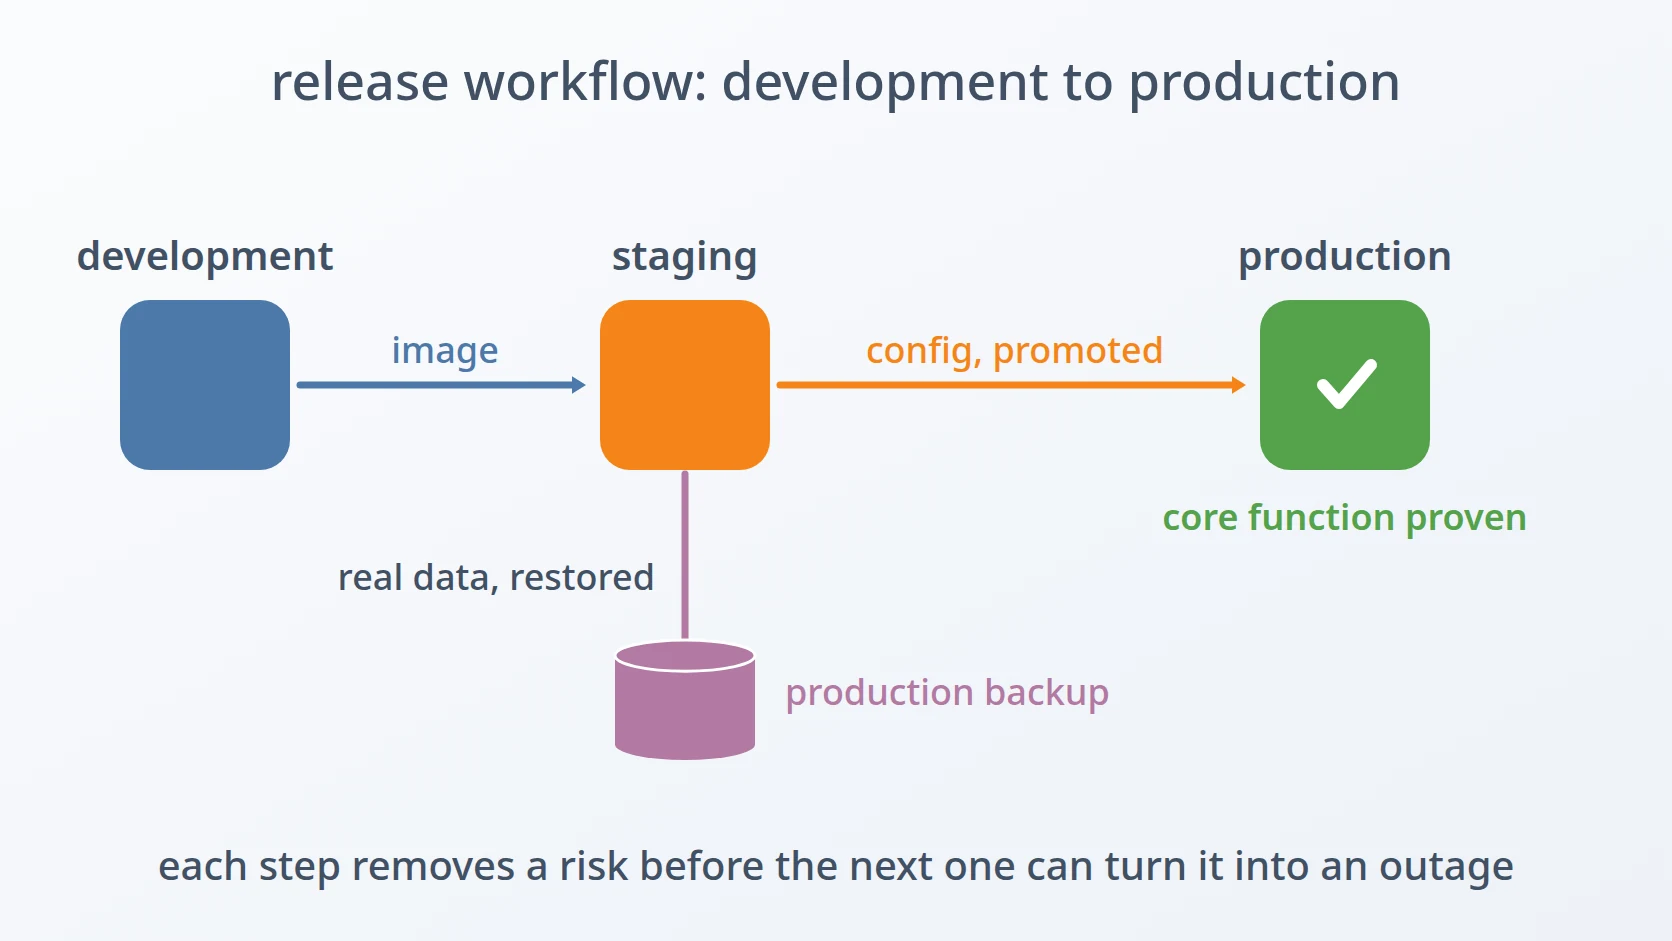
Urutannya bukan urutan saya menemuinya, melainkan urutan yang harus dipakai untuk menyelesaikannya. Yang pertama didahulukan karena selama telemetry belum tiba dengan andal, sisanya tak akan pernah terlihat — duplikat yang tak pernah diterima bukan duplikat yang bisa dihitung. Yang kedua mendahului yang ketiga karena cara menemukannya berbeda: duplikasi cuma mungkin tertangkap dengan menghitung dokumen lalu membandingkan totalnya dengan yang seharusnya, sedangkan kegagalan template cukup berisik untuk mendatangi saya sendiri. Yang keempat dan kelima ditaruh terakhir sebab keduanya soal apa arti datanya setelah tersimpan dengan selamat, bukan soal apakah ia sampai — trace yang terbelah dan metric yang meledak sama-sama data yang tersimpan rapi tapi menjawab pertanyaan yang keliru. Hambatan yang gagal dengan ribut boleh menunggu. Yang justru terus bekerja, itulah yang layak dicari lebih dulu.
Metode
A. Satu titik pengumpulan, dan collector yang tak berbuat pintar-pintar
Tiap service yang terinstrumentasi mem-push ke satu collector lewat OTLP. Tak ada scraping, tak ada pengumpulan file log — tak ada receiver filelog yang membaca keluaran container, tak ada receiver Prometheus yang menyurvei endpoint. Collector cuma menerima OTLP pada dua protokol dan tak melayani yang lain, jadi service yang ingin diamati harus menyatakannya terang-terangan dengan mengirim data.
receivers:
otlp:
protocols:
grpc:
http: Pilihan itu layak dibela, sebab justru scraping yang lebih lazim jadi default. Scraping menuntut collector mengenal setiap service, alamat, dan port-nya, dan daftar itu lambat laun menjadi artefak deployment kedua yang melenceng. Push membalik arah ketergantungan: collector tak tahu apa-apa soal siapa yang bicara padanya, dan menambah service cukup mengubah service itu saja. Konfigurasi collector tak berubah berbulan-bulan di tiga deployment terpisah, karena tak ada isinya yang menyebut siapa pun.
Rantai processor-nya cuma dua entri, dan urutannyalah yang menanggung beban.
processors:
memory_limiter:
batch: Memory limiter harus lebih dulu. Tugasnya menolak data ketika proses mendekati batas atasnya, dan itu hanya bisa ia lakukan bila data lewat di depannya sebelum ada komponen lain yang menimbunnya. Taruh batch di depan, dan yang terbangun adalah komponen yang seluruh tujuannya menahan data di memory, duduk di hulu komponen yang seluruh tujuannya mencegah data ditahan di memory. Limiter lalu melaporkan tekanan yang diciptakan batch, tekanan yang justru tak berdaya ia redakan.
Di luar dua itu, collector tak berbuat apa-apa. Tak ada enrichment, filtering, penulisan ulang atribut, maupun sampling. Saya memandangnya sebagai pipa bodoh yang disengaja, dan itu keputusan rancangan, bukan konfigurasi yang belum rampung. Tiap potong struktur semantik — nama service, template route, hasil satu operasi — diproduksi aplikasi yang memang mengetahuinya. Aturan di collector yang menyimpulkan makna dari path atau header cuma salinan kedua yang lebih lemah dari pengetahuan yang sudah ada di sumbernya, dan cepat atau lambat ia akan berselisih dengan sumber itu.
Satu catatan lagi soal bentuk: ada satu exporter yang dipakai bersama tiga pipeline, bukan satu exporter per signal. Logs, traces, dan metrics semuanya menuju exporter yang sama, yang sudah tahu sendiri cara menempatkan tiap signal. Alternatifnya — tiga blok exporter yang nyaris identik — berarti tiga tempat memperbarui credential dan tiga kesempatan bagi ketiganya untuk berbeda.
B. Restart yang selalu memakan menit-menit pertama
Inilah jawaban atas hambatan pertama: telemetry yang tak pernah selamat melewati restart.
Stack ini punya gejala yang saya toleransi lebih lama dari semestinya. Setiap kali restart, menit-menit pertama telemetry raib. Bukan rusak, bukan terlambat — tak ada. Collector menyatakannya dengan gamblang, dan saya sudah terlalu sering membaca pesan itu sampai berhenti melihatnya.
Pembacaannya lurus saja begitu dituliskan. Collector naik, mencoba mengirim, mendapati store menolak koneksi, mengulang, kehabisan pengulangan, lalu membuang apa yang sedang dipegangnya. Dua sebab yang saling bebas harus sama-sama terpenuhi agar data hilang, dan karena itulah perbaikannya butuh dua bagian.
Yang pertama soal aritmetika. Kebijakan retry lima percobaan dengan backoff default habis dalam kira-kira tiga puluh detik, padahal store butuh waktu terasa lebih lama dari tiga puluh detik untuk sehat dari keadaan dingin. Selisihnya kecil sekali sampai tampak seperti nasib buruk belaka, dengan retry menyerah sesaat sebelum tujuannya siap.
Yang kedua soal di mana data itu menunggu. Bila sending queue ada di memory, kehabisan retry bukan menunda data, melainkan memusnahkannya. Queue di memory bukan penyangga terhadap outage. Ia penyangga terhadap sendatan sesaat, dan segala yang lebih lama dari itu ia ubah menjadi kehilangan.
Pengamatan yang terus saya datangi kembali justru soal mekanisme yang semestinya mencegah semua ini. Dependency dengan kondisi health di compose file memang sungguh ditegakkan, dan tetap tak menahan apa pun ketika kedua container start dalam detik yang sama dan store melaporkan sehat tepat saat collector bertanya. Kondisi urutan startup cuma menandakan satu container sudah mulai lulus health check-nya. Ia sama sekali tak menjamin service di belakangnya siap menerima tulisan, dan di celah antara dua fakta itulah telemetry menghilang.
extensions:
  file_storage:
    directory: /var/lib/otelcol/storage
sending_queue:
  storage: file_storage
retry:
  max_retries: 8
  initial_interval: 5s
  max_interval: 60s
Karena itu queue-nya menunggu di disk, dan jendela retry-nya sekitar lima menit, bukan lagi tiga puluh detik. Queue di disk adalah paruh yang lebih penting. Ia mengubah mode kegagalan dari "telemetry hilang selagi store mati" menjadi "telemetry tertunda selagi store mati", dan data yang tertunda tetap bisa menjawab pertanyaan di kemudian hari. Melebarkan retry saja hanya menutupi balapan startup yang satu ini, sementara outage yang lebih panjang tetap sama merusaknya.
C. Dua jebakan yang saya catat supaya tak terulang
Keduanya terang benderang setelah kejadian sekaligus tak terlihat sebelumnya, jadi masing-masing saya simpan sebagai catatan bertanggal di samping konfigurasi yang bersangkutan.
Pertama, field yang paling jelas untuk menyatakan jendela retry justru ditolak. Menyetel max_elapsed_time terasa paling wajar untuk berkata "teruslah mencoba selama lima menit", padahal field itu milik pembantu retry generik, bukan milik blok retry pada exporter ini. Collector menolak start, melaporkan bagian retry punya kunci tak sah, lalu masuk restart loop — outage telemetry total, dipicu perubahan yang niatnya justru membuat telemetry lebih andal. Jendelanya harus dinyatakan tak langsung: sebagai jumlah retry beserta interval di antaranya.
Kedua, masalah permission dengan radius ledakan yang luar biasa buruk. Proses collector berjalan sebagai user non-root dengan identifier tinggi yang tak mencolok, dan bukan identifier itu yang memiliki direktori data lain pada stack yang sama. Membuat direktori queue tanpa menyamakan kepemilikannya menghasilkan collector yang tak bisa menulis queue-nya sendiri, dan karenanya tak mau start. Ongkos salah di sini: seluruh service kehilangan telemetry tanpa batas waktu, demi memperbaiki gangguan yang harganya beberapa detik data per restart.
Karena itulah konfigurasinya kini divalidasi sebelum stack yang berjalan disentuh sama sekali. Image collector bisa memeriksa config file tanpa menjalankan pipeline, dan menjalankannya sebagai user yang nanti dipakai container menangkap kedua kelas error itu dalam satu perintah. Tanpa keluaran berarti sah.
Rancangan ini saya uji dengan merusak sistem secara sengaja: matikan store-nya, kirim trafik, lalu hidupkan lagi. Queue di disk memegang tiga file dan sekitar 112 KB selama store-nya hilang. Tak ada pesan drop saat startup, traces dan metrics sama-sama memulihkan tunggakannya, dan situs publiknya melayani respons normal sepanjang waktu itu. Satu detail dari pengujian tadi saya taruh di bagian hasil, sebab ia mengajari saya sesuatu tentang logs.
D. Instrumentation: tiga bahasa, satu bentuk
Empat service dalam tiga bahasa terinstrumentasi, dan yang saya pedulikan adalah bentuknya sama, bukan kodenya sama. Semuanya mengekspor ketiga signal. Semuanya bicara OTLP lewat HTTP dengan encoding protobuf ke port yang sama, tak pernah gRPC, dan semuanya menyusun URL per signal dengan menambahkan path pada satu endpoint terkonfigurasi — jadi satu environment variable memindahkan setiap signal untuk setiap service.
Memilih HTTP ketimbang gRPC bukan soal performa, karena pada volume segini tak ada yang bisa didapat. Yang jadi pertimbangan adalah sesedikit apa dependency yang dibutuhkan tiap service. Bedanya paling terasa di service PHP: OTLP lewat HTTP keluar melalui HTTP client biasa yang sudah dibawa framework-nya, tanpa perlu ekstensi terkompilasi maupun tumpukan gRPC. Client telemetry yang menuntut ekstensi native cepat atau lambat akan menghambat upgrade runtime.
Service Rust memperlihatkan strukturnya paling jelas, karena ketiga signal tampak dalam satu ekspresi. Satu registry subscriber membawa tiga layer: keluaran terbaca manusia untuk terminal, jembatan yang mengubah span menjadi traces OTel, dan jembatan yang mengubah pernyataan log menjadi log record OTel.
registry
.with
.with // stdout, untuk manusia
.with // spans -> traces
.with // events -> logs
.init;Hasil dari susunan itu: kode biasa tetap biasa. Developer menulis fungsi terinstrumentasi dan pernyataan log memakai API yang sama persis dengan yang ia pakai tanpa telemetry sama sekali, dan korelasinya terjadi di layer, bukan di call site. Prinsip yang sama muncul di dua bahasa lain lewat mekanisme berbeda: handler logging library standar di Python yang membaca span yang sedang aktif, dan jalur log ber-scope aktif di PHP.
Di Python jembatan itu cuma dua baris. Satu handler dari SDK dipasang ke root logger, dan sejak itu tiap panggilan logging biasa di service itu sekaligus menjadi OTel log record, berstempel span mana pun yang sedang aktif saat itu.
# Bridge stdlib logging -> OTel logs, correlated with the active span.
=
Tiap service menyetel resource attribute yang sama: nama service, namespace, versi dari metadata build, dan environment deployment. Field-field inilah yang membuat dashboard bisa difilter, dan membuat "apakah ini cuma terjadi di satu environment" menjadi pertanyaan yang ada jawabannya.
Ada satu aturan di atas semua ini, dan saya menyebutnya aturan karena ia menentukan rancangan setiap jalur inisialisasi: telemetry tak boleh menjadi titik gagal. Ketika telemetry dimatikan atau salah konfigurasi, tiap service jatuh kembali ke logger lokal biasa — service Rust ke subscriber pemformat, service Python ke konfigurasi logging dasar, service PHP ke provider noop yang ditukar di balik interface yang sama. Tak ada satu pun tempat yang bercabang berdasarkan telemetry menyala atau mati. Sistem pemantauan yang sanggup menjatuhkan apa yang ia pantau sudah membalik tujuannya sendiri.
E. Propagation: bagaimana satu transaksi tetap satu transaksi
Inilah jawaban atas hambatan keempat, dan seksi ini membahas batas yang memang membawa header. Seksi berikutnya membahas yang tidak.
Trace hanya ada karena tiap service memberi tahu service berikutnya ia bagian dari trace yang mana. Itu berjalan lewat satu header yang membawa identifier trace, identifier span saat ini, dan satu flag, dan header itu harus di-inject setiap pemanggil serta di-extract setiap yang dipanggil. Lewatkan salah satu paruhnya pada hop mana pun, trace-nya tidak error — ia diam-diam pecah menjadi dua trace yang tak berhubungan.
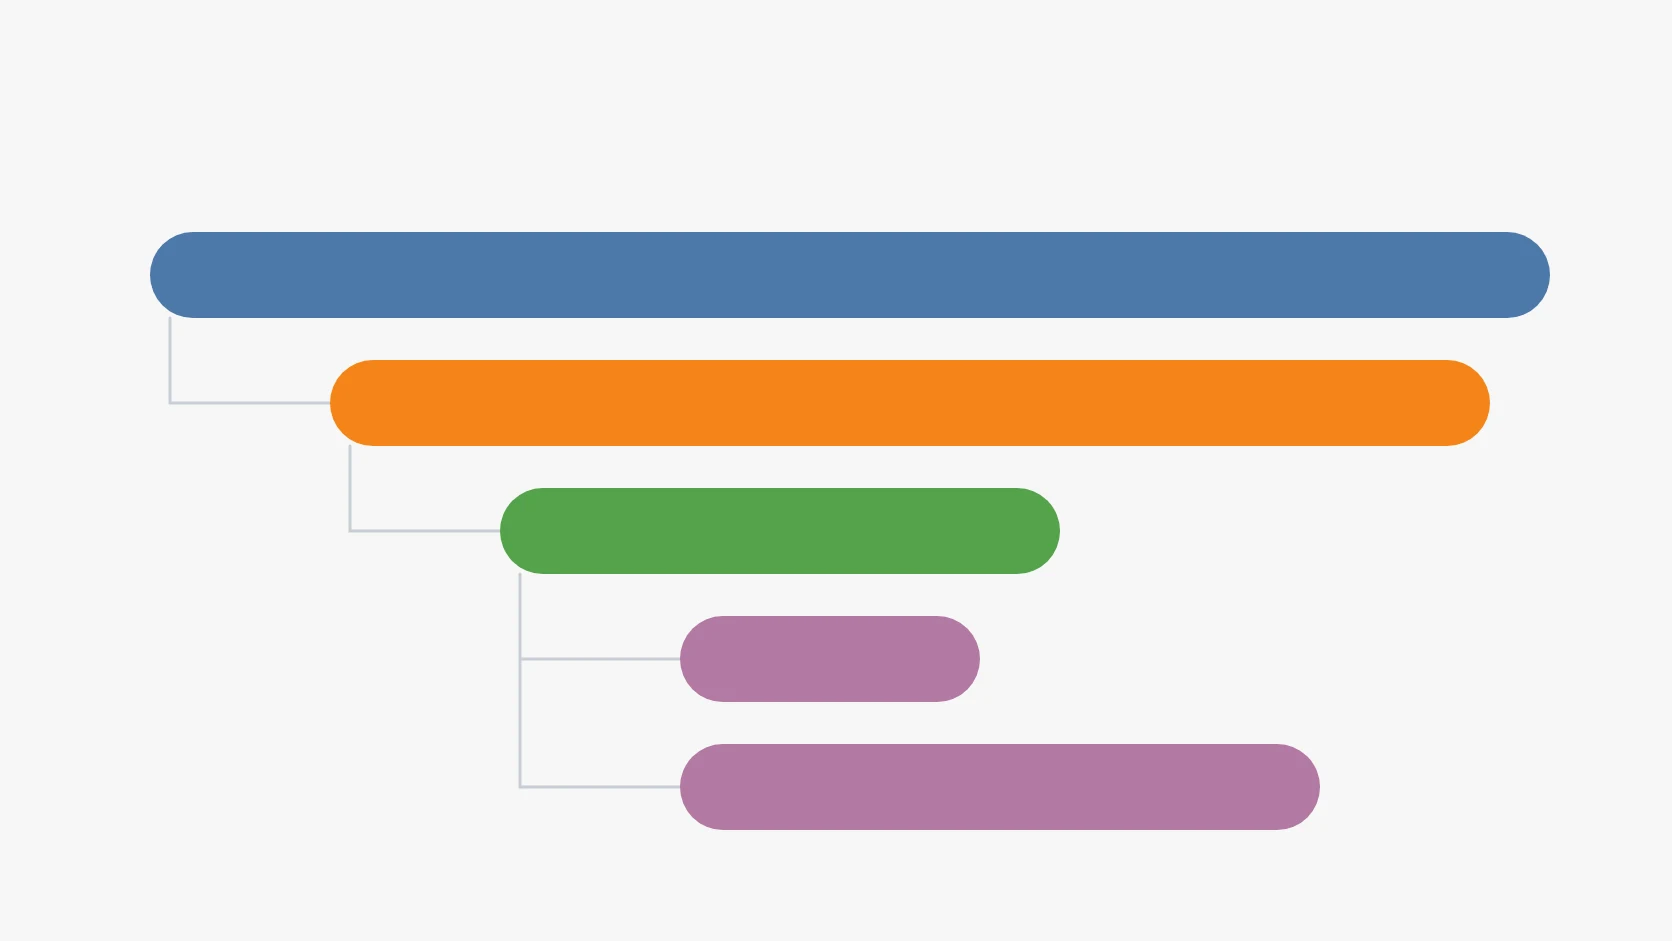
Di sisi penerima, server meng-extract context masuk lalu menjadikan span-nya sendiri anak dari context itu. Komentar di sumbernya menyebut kegagalannya dengan tepat, sebab pembaca masa depan yang menghapus baris ini tak akan melihat apa pun rusak.
// Extract inbound `traceparent` so this span becomes a child of the caller's
// trace rather than a new root — the parent breaks here if this is skipped.
let parent_cx = extract_context_from_headers;
let span = info_span!;
let _ = span.set_parent;Komentar kedua di dekatnya sama pentingnya: untuk request yang tak datang lewat gateway memang tak ada header masuk, dan span-nya secara sah menjadi root. Tanpa catatan itu, orang pertama yang melihat root span pada service yang biasanya berada di hilir akan sibuk memburu bug propagation yang tak pernah ada. Mendokumentasikan ketiadaan yang memang diharapkan sama bergunanya dengan mendokumentasikan keharusannya.
Di sisi pengirim, gateway meng-inject context ke request keluar. Posisinya di dalam kode disengaja dan ditulis sebagai invarian, karena penanganan header pada gateway adalah batas keamanan sekaligus batas observability: buang header hop-by-hop, singkirkan header client yang bisa dipalsukan pemanggil, setel nilai-nilai tepercaya, tambahkan rantai forwarding, baru setelah itu propagasikan trace context. Injection diletakkan paling akhir justru supaya ia berjalan setelah himpunan yang bisa dipalsukan dibuang, dan tak akan pernah menjadi celah bagi header kiriman pemanggil untuk lolos.
// Propagate W3C trace context (traceparent) to the backend.
for in inject_context Di PHP operasi yang sama menyimpan jebakan yang lebih berharga daripada kodenya. Propagator global bersifat noop sampai ada yang mendaftarkannya secara eksplisit, sehingga pemanggilan yang tampak idiomatis itu tidak meng-inject apa-apa, tetap dianggap sukses, dan menghasilkan trace yang patah. Menyebut propagator-nya secara langsung melepaskan ketergantungan pada urutan registrasi yang entah terjadi di mana.
Di Python hampir tak ada dari semua ini yang ditulis tangan. Meng-instrument framework web-nya memberi span server sekaligus extraction-nya; meng-instrument HTTP client-nya memberi span client sekaligus injection-nya. Dua panggilan saat startup sudah membeli kedua sisi kontrak propagation untuk seluruh route dan seluruh request keluar di service itu.
# Server span per request, and extraction of the caller's traceparent.
# Client spans for outbound calls, and injection of traceparent downstream.
Yang tersisa dan layak ditulis manual adalah span bernama di sekitar satu unit kerja yang bermakna, supaya pemanggilan library di dalamnya muncul sebagai anak dari operasi yang berarti bagi manusia, bukan sebagai deretan request yang datar.
F. Batas-batas yang bukan HTTP
Masih hambatan keempat, dan di sinilah ia benar-benar menggigit.
Propagation lewat HTTP sudah terlalu sering dilalui. Batas yang mematahkan trace justru tiga batas yang tak punya pasangan request-response untuk membawa header, dan ketiganya gagal dengan cara berbeda.
Message queue menghasilkan kegagalan paling instruktif, karena ia tidak gagal. Trace context berjalan di header pesan, dan consumer-nya mencocokkan satu tipe string tertentu saat membacanya. Kirim header yang sama sebagai tipe string yang berbeda: pesannya tetap terkirim normal, consumer-nya berjalan normal, dan header-nya diabaikan diam-diam — span-nya sekadar kehilangan induk, dan tak ada error yang muncul di mana pun.
// ⚠️ Trace headers MUST be LongString.
// The consumer matches `if let AMQPValue::LongString(s) = v` and silently
// ignores other types. Using ShortString breaks the trace silently: the
// message still arrives, but the consumer's span loses its parent and not
// a single error appears.
Background job melintasi batas dalam waktu, bukan dalam ruang, dan mekanismenya adalah memperlakukan context sebagai data. Saat dispatch, trace context ditangkap sebagai string lalu disimpan di payload job seperti field lain. Di worker ia dihidupkan kembali dengan menyerahkan carrier sintetis berisi nilai itu saja kepada propagator, lalu diaktifkan selama job berjalan, dengan detach ditaruh di blok finally supaya job yang gagal tak meninggalkan context aktif yang mengotori pekerjaan berikutnya.
Batas thread paling halus, sebab kodenya tampak tetap berada di satu tempat. Context disimpan di thread-local storage, jadi memindahkan pekerjaan ke thread worker meninggalkannya, dan span yang lahir di sana menjadi root. Perbaikannya sama: attach dan detach eksplisit di dalam fungsi yang berjalan di thread lain itu, dengan detach kembali ditaruh di finally.
Satu konsistensi yang disengaja melintasi semuanya: setiap injection dan setiap rehidrasi lewat propagator SDK, tak pernah lewat manipulasi string. Ada tepat satu tempat di dalam codebase yang mengurai header itu dengan tangan, dan sifatnya baca saja — menarik identifier trace untuk disimpan pada record audit, dengan validasi dan kembalian opsional bila bentuknya cacat. Itu pembacaan di daun yang tak bisa memengaruhi bentuk trace mana pun. Penguraian tangan yang terkurung di daun tak masalah; penguraian tangan atas apa pun yang menentukan keinduk-an adalah resep untuk trace yang keliru secara halus, bukan rusak secara terang-terangan.
Hasil dan Pembahasan
A. Untuk apa logs, setelah traces ada
Korelasi log berjalan otomatis di ketiga bahasa lewat tiga mekanisme berbeda, dan ketiganya tiba di tempat yang sama: tiap log record membawa identifier trace dan span dari operasi tempat ia ditulis, tanpa apa pun di call site. Di Rust sebuah layer subscriber menstempelnya; di Python sebuah handler logging membaca span yang aktif; di PHP record dipancarkan selagi span request aktif, ditimbun untuk request itu, lalu dikuras di akhirnya.
Jalur PHP paling ganjil, dan layak dicatat karena ia mengejutkan saya: record yang berkorelasi keluar langsung lewat logger provider OTel dan melompati sama sekali library logging yang biasa dipakai framework-nya. Itu tradeoff yang nyata. Artinya konfigurasi logging yang dikira seorang developer PHP mengendalikan keluaran ternyata tak mengendalikan jalur ini, dan siapa pun yang men-debug "kenapa handler saya tidak jalan" perlu tahu jalur itu ada.
Konsekuensi yang mengubah cara saya menulis instrumentation: span sendirian tidak menghasilkan baris log. Request yang sukses dan tak mencatat apa-apa meninggalkan span yang sempurna tanpa satu pun log record. Saya mengira kedua signal itu kurang lebih akan seiring, ternyata tidak — traces meliputi setiap request, logs hanya meliputi request yang kodenya punya sesuatu untuk dikatakan. Maka tiap service memancarkan satu event akses eksplisit di dalam span request, mewarisi atribut dan identifier-nya, dan itu memulihkan kemampuan menjawab pertanyaan di tampilan logs tanpa harus menalar lewat span lebih dulu.
Itu juga catatan dari pengujian outage tadi. Ketika store-nya kembali, traces dan metrics sama-sama menunjukkan pemulihan data tertahan yang jelas, sementara logs tak menunjukkan apa pun — bukan karena queue-nya gagal untuk logs, melainkan karena tak ada service yang menulis baris log selama jendela itu. Request yang sukses memancarkan span, bukan baris log. Diuji terpisah dengan service yang memang mencatat, tunggakan log-nya pulih persis seperti dugaan.
Asimetri lain yang disengaja adalah soal apa yang dibuang. Health probe berjalan tiap tiga puluh detik selamanya dan tak bernilai forensik, jadi ia dikecualikan dari logs — tapi span dan metrics-nya tetap disimpan, karena health check yang mulai memakan dua detik adalah signal nyata, dan metrics-lah tempat gejalanya terlihat. Menyaring per signal, bukan per request, hanya mungkin karena ketiganya diproduksi terpisah.
B. Event audit yang tersimpan dua kali
Inilah jawaban atas hambatan kedua, dan hanya dengan menghitunglah ia bisa ditemukan.
Duplikat semacam ini ditemukan dengan menghitung, bukan dengan memperhatikan. Merekam event audit dengan dua cara sekaligus — sebagai log record, dan sebagai event yang ditempelkan pada span aktif — kelihatannya tak berbahaya, malah terkesan pengamanan berlapis.
Perilaku yang membuatnya berbahaya justru detail storage. Span event tidak mendarat di data stream traces. Exporter menulisnya ke data stream logs, berdampingan dengan log record biasa. Jadi event audit yang direkam dengan dua cara tersimpan dua kali, dengan identifier span yang sama, berselisih sekitar satu milidetik, di index yang sama — dua dokumen menggambarkan satu peristiwa, tanpa penanda apa pun pada keduanya bahwa yang satu duplikat dari yang lain.
| Yang dihitung | Mendarat di mana | Dokumen |
|---|---|---|
| Dokumen audit di data stream logs | logs-* | 53 |
| — darinya, dipancarkan sebagai log record | logs-* | 28 |
| — darinya, dipancarkan sebagai span event | logs-* | 25 |
| Span event di data stream traces | traces-* | 0 |
Karena itu tiap service memancarkan log record saja. Pelajarannya lebih umum daripada mekanisme yang satu ini — jejak audit adalah klaim tentang berapa kali sesuatu terjadi, sehingga mekanisme apa pun yang bisa diam-diam menggandakan barisnya adalah masalah kebenaran, bukan masalah kerapian. Dan duplikat semacam ini tak terlihat justru karena kedua penulisannya berhasil. Tak ada yang gagal. Satu-satunya cara melihatnya adalah menghitung apa yang ada lalu membandingkannya dengan apa yang seharusnya ada.
C. Metrics, dan ongkos satu label yang ceroboh
Inilah jawaban atas hambatan kelima: yang hari ini tak berongkos apa pun, dan sangat berongkos pada artikel ke-sepuluh ribu.
Tiap service mengekspor himpunan instrumen yang kecil dan tetap, bukan segala yang bisa ia ekspor. Jumlah request sebagai counter dan durasi request sebagai histogram, keduanya berlabel metode HTTP, route, dan status code, diekspor lewat reader periodik tiap sepuluh detik. Itu cukup untuk melihat trafik, error rate, dan distribusi latensi per route, dan itu mencakup sebagian besar yang benar-benar saya tanyakan.
Dua detail implementasi kurang kentara. Delta temporality bersifat wajib, bukan sekadar disukai, karena exporter dalam mode time-series menolak counter dan histogram kumulatif mentah-mentah — detail yang pantas ditaruh sebagai komentar di samping konfigurasinya, sebab gejalanya muncul berupa penolakan saat menulis, jauh dari kode yang memilihnya. Lalu service PHP sama sekali tak bisa memakai reader periodik, karena prosesnya tak hidup lebih lama dari request-nya; ia memakai reader yang dikumpulkan manual lalu dikuras di akhir tiap request, dan tetap memilih delta, supaya instrumen yang sama dari dua service berarti sama.
Mode kegagalan yang paling saya pedulikan adalah cardinality, karena ia menggerogoti storage, bukan kodenya. Melabeli metric request dengan path, bukan dengan template route, berarti tiap URL yang berbeda melahirkan time series baru, sehingga situs dengan sepuluh ribu artikel punya sepuluh ribu series untuk satu instrumen.
// Route TEMPLATE, never the raw path: `/blog/{slug}` is one time series,
// `/blog/an-actual-article-title` is one per article.
let route = matched_route.unwrap_or_else;Di tempat routing-nya dinamis dan template tak tersedia, path diciutkan menjadi pola dengan tangan. Tidak glamor, tapi tradeoff-nya benar: sedikit pemetaan eksplisit, dipelihara orang-orang yang tahu bagian mana dari path yang merupakan identifier, ditukar dengan tertahannya pertumbuhan tak berbatas di metrics store.
Dua tambahan sudah berkali-kali membayar dirinya sendiri. Pertama, gauge teramati yang melaporkan pemakaian pool koneksi basis data, dipecah menjadi menganggur dan terpakai. Habisnya pool adalah kegagalan yang menampakkan diri sebagai latensi tak terjelaskan lalu berubah jadi error, dan tanpa gauge itu bukti pertamanya adalah keluhan user; dengannya, kejenuhan terlihat di dashboard sebelum menjelma outage. Kedua, counter untuk peristiwa bisnis, bukan infrastruktur — dokumen ditandatangani, sertifikat diterbitkan dan dicabut, job diproses — masing-masing dengan label hasil, sehingga sukses dan gagal menjadi pembelahan dari series yang sama, bukan dua angka yang tak berhubungan.
Pola yang paling saya sukai justru yang paling kecil: panggilan client keluar memancarkan histogram durasi sekaligus counter dari blok finally yang sama. Karena keduanya direkam bersamaan tepat di titik panggilan berakhir, setiap panggilan keluar yang terinstrumentasi otomatis menghasilkan keduanya, dan tak ada jalan menambahkan panggilan yang punya waktu tapi tak punya hitungan.
D. Storage, mapping, dan template yang bisa mematahkan metrics saja
Inilah jawaban atas hambatan ketiga: template buatan sendiri yang bisa menggantikan mapping yang justru saya butuhkan.
Data mendarat sebagai data stream OTel-native, bukan pada skema umum yang lebih lama, dan itu lebih penting daripada kedengarannya: ia menentukan index template dan mapping mana yang berlaku, dan mencampur kedua asumsi itu adalah cara termudah membuat mapping tertimpa.
Jebakan ini mudah dimasuki. Cluster satu node semestinya tak meminta replica yang tak bisa ia tempatkan, jadi perbaikan yang tampak masuk akal adalah satu template tangkap-semua yang menyetel jumlah replica jadi nol untuk segalanya. Template itu diam-diam menggantikan mapping resmi yang disertakan untuk data stream ini, dan kegagalannya sempit sekaligus tertunda: logs jalan terus, traces jalan terus, dan metrics mulai ditolak dengan parsing error yang mengeluhkan dynamic template yang ia butuhkan tidak ada. Metrics bergantung pada dynamic template itu untuk menentukan tipe field numeriknya; logs dan traces sebagian besar tidak.
Jawabannya adalah komposisi, bukan penimpaan. Satu component template mungil memuat satu setelan yang memang ingin saya ubah, dan satu index template per signal mengomposisikan component bawaan ditambah yang satu itu, dengan milik saya terdaftar paling akhir supaya ia menang pada setelan tersebut tanpa mengganti apa pun yang lain. Urutannya adalah seluruh mekanismenya: penulis terakhir menang per field, jadi component minimal di posisi akhir mengubah tepat satu hal.
{ }Satu lagi yang mudah terlewat: memperbaiki template tidak memperbaiki index yang terlanjur dibuat dari template yang rusak. Backing index mempertahankan mapping yang menyertainya sejak lahir, jadi rollover diperlukan untuk memaksa data stream-nya pindah ke index baru yang dibangun dari template yang sudah benar. Sebelum itu dilakukan, perbaikannya nyata tapi error-nya berlanjut, dan itu lima menit yang membingungkan.
Credential yang dipakai collector dibatasi sesuai kebutuhan seorang penulis: hak index terbatas pada pola data stream spesifik yang ia tulis, tanpa akses ke index keamanan, tanpa data bisnis, tanpa hak hapus. Prinsip yang saya nyatakan tanpa syarat: komponen dengan paparan jaringan terluas seharusnya memegang credential tersempit, karena pipeline telemetry menerima data dari segalanya dan karenanya jadi sasaran paling menggiurkan di seluruh stack.
E. Membacanya: data view, satu runtime field, dan dashboard sebagai artefak
Tiga data view, satu per signal, dibuat dengan identifier stabil, bukan yang dibangkitkan otomatis. Detail itu terkesan administratif, padahal ia pembeda antara dashboard yang bisa diekspor dan diimpor ulang di mana saja dengan dashboard yang patah di cluster baru, karena saved object merujuk data view lewat identifier.
Hal kecil paling berguna di seluruh lapisan visualisasi adalah runtime field. Durasi span tiba dalam nanodetik — benar, sekaligus tak terbaca; sumbu berlabel ratusan juta tak mengomunikasikan apa-apa. Satu field terhitung membaginya menjadi milidetik pada saat query, dengan penjaga untuk nilai yang tak ada.
Saya menyukainya karena tempat transformasi itu tinggal. Ia bisa saja dikerjakan di exporter, yang berarti menulis ulang data saat masuk dan terjebak pada pilihan itu; atau saat ingest, yang berarti reindex setiap kali ingin mengubahnya. Sebagai runtime field, ia tak berbiaya sampai di-query, berlaku surut atas data yang sudah tersimpan, dan bisa diubah dengan menyunting satu definisi.
Dashboard-nya sendiri disimpan di repository sebagai objek terekspor dan diimpor lewat API saved object dengan flag overwrite menyala, dan flag itulah yang membuat impor ulang bersifat idempoten ketimbang berujung error. Putaran pemeliharaannya sengaja satu arah: sunting di antarmuka tempat menyunting terasa nyaman, ekspor dengan objek terkait disertakan, timpa file-nya di repository, lalu impor ulang di tempat lain untuk mereplikasi. Antarmukanya adalah editor; file-nya adalah sumber kebenaran.
Empat dashboard, masing-masing menjawab satu pertanyaan: forensik dan audit, error dan keandalan, performa dan trafik, serta kesehatan service. Dashboard error satu-satunya yang membentang di dua data view, logs dan traces sekaligus, dan itulah yang pertama saya buka — sebab error justru kasus yang menuntut keduanya: apa yang dikatakan kodenya, dan di titik mana dalam transaksi ia mengatakannya.
Terakhir, paparan bidang bacanya, yang ternyata properti satu baris ketimbang satu subsistem. Karena pemetaan port menerima alamat di sisi kirinya, mengikat antarmuka administratif ke interface jaringan privat cukup mengubah satu variabel.
ports:
  - "${KIBANA_PORT}:5601"   # mis. 10.x.x.x:5601 — hanya interface VPN
Tanpa reverse proxy, tanpa aturan firewall, tanpa listener publik yang perlu dilindungi. Versi yang lebih ketat dari gagasan yang sama: jangan menerbitkan port host sama sekali untuk store-nya, sehingga ia hanya terjangkau lewat jaringan container berdasarkan nama, dan satu-satunya yang punya ikatan ke host adalah antarmuka yang memang dibutuhkan manusia.
Simpulan
Kalau harus menyimpan satu kalimat dari semua ini: observability adalah persoalan pemodelan data yang mengenakan kostum operasional. Bagian sulitnya tak pernah soal mengirim byte ke satu tempat terpusat; itu urusan satu collector dan satu sore. Bagian sulitnya adalah memutuskan struktur apa yang harus dimiliki datanya, dan jawabannya sama dengan jawaban untuk model data mana pun: taruh strukturnya di tempat maknanya berada, yaitu di aplikasi, dan biarkan setiap lapisan di hilirnya tetap bodoh.
Ketiga signal bertahan sebagai pembagian kerja karena ketiganya sungguh menjawab pertanyaan berbeda, dan disiplinnya adalah menjaga agar ketiganya tak melenceng menjadi tiga salinan dari satu benda. Traces untuk struktur dan kausalitas. Logs untuk penalaran — artinya baris log yang mengulang apa yang sudah dikatakan span cuma derau, sementara baris log yang menjelaskan mengapa satu cabang diambil berharga sepuluh kali lipat. Metrics untuk perilaku agregat — artinya musuhnya adalah label tak berbatas, dan nilainya adalah kemampuan dijawab seketika pada jendela waktu yang panjang. Korelasikan ketiganya pada satu identifier, dan kita bisa masuk dari ujung mana pun yang tersedia — keluhan user, sebuah alert, anomali pada grafik — dan tetap sampai ke transaksi yang sama.
Kegagalannya menggeneralisasi lebih baik daripada rancangannya. Telemetry yang dibuang ketika tujuannya tak tersedia bukanlah sistem pemantauan, melainkan sistem pemantauan yang buta persis pada insiden yang menjadi alasan keberadaannya, dan perbaikannya adalah queue yang bertahan melampaui prosesnya, bukan timeout yang lebih panjang. Dependency yang start pada detik yang sama dengan yang bergantung padanya belum benar-benar diurutkan, karena kesiapan dan kehidupan bukan klaim yang sama. Lalu, perubahan yang niatnya membuat telemetry lebih andal bisa menjatuhkan telemetry sepenuhnya, dan itulah argumen untuk memvalidasi konfigurasi di luar jalur sebelum menyentuh apa pun yang sedang berjalan.
Tak ada satu pun dari ini yang bergantung pada stack saya. OpenTelemetry, collector itu, dan store itu kebetulan saja yang saya jalankan; metodenyalah yang bertahan ketika ketiganya diganti. Ajukan pertanyaan ini pada sistem sendiri: apakah telemetry bermuara di satu tempat, atau di banyak tempat? Apakah makna dilekatkan di sumbernya, atau disimpulkan di hilir oleh komponen yang cepat atau lambat akan berselisih dengan sumbernya? Apakah satu identifier menghubungkan keluhan seorang user ke satu operasi spesifik di satu service spesifik? Bisakah store-nya mati sepuluh menit tanpa kehilangan catatan tentang apa yang terjadi selama sepuluh menit itu? Pertanyaan-pertanyaan itu punya jawaban yang sama apa pun tools yang dipilih, dan jawabannya lebih penting daripada tools-nya.
Dan apa pun yang dibangun, pegang aturan yang menentukan setiap jalur inisialisasi di sistem ini: telemetry tak boleh menjadi titik gagal. Begitu yang mengawasi sistem sanggup menghentikan sistemnya, yang bertambah adalah risiko demi visibilitas — dan justru pertukaran itulah yang tadinya kita kira sedang dihindari.
Istilah
- OpenTelemetry
- Standar terbuka, dengan library untuk kebanyakan bahasa pemrograman, yang mengatur cara program mencatat logs, traces, dan metrics lalu mengirimkannya ke collector.
- OTLP
- OpenTelemetry Protocol: format wire yang dipakai service untuk mengirim logs, traces, dan metrics ke collector, tersedia lewat HTTP maupun gRPC.
- Span
- Satu operasi berwaktu di dalam trace, membawa awal, durasi, atribut, dan rujukan ke induknya — unit yang menyusun struktur pohon trace.
- Trace context
- Identifier yang menyatakan satu operasi termasuk trace mana dan span mana induknya, dibawa antar service lewat header standar supaya satu transaksi tetap satu transaksi.
- Propagator
- Komponen yang menulis trace context ke carrier keluar dan membacanya dari carrier masuk. Memakainya, ketimbang memformat header dengan tangan, itulah yang menjaga struktur trace tetap benar.
- Cardinality
- Banyaknya kombinasi label berbeda pada satu metric, dan karenanya banyaknya time series yang ia ciptakan. Melabelinya dengan nilai tak berbatas seperti path mentah membuatnya tumbuh tanpa batas.
- Delta temporality
- Melaporkan perubahan satu metric sejak ekspor terakhir, bukan total berjalan. Diwajibkan sebagian backend storage, dan sifat yang harus konsisten antar service agar instrumennya bisa dibandingkan.
- Data stream
- Abstraksi append-only di atas serangkaian backing index. Karena tiap backing index mempertahankan mapping saat ia dibuat, perbaikan template baru menjangkau data baru setelah rollover.
- Runtime field
- Field yang dihitung saat query dari data tersimpan, bukan ditulis saat ingest, sehingga bisa diubah secara surut dan tak berbiaya sampai ia di-query.
Technologies covered
- PHP
- Python
- Rust
- Elasticsearch
- Docker
- Kibana
- OpenTelemetry